Hallo Marcel,
Du hast erkennbar das Prinzip der großen Zahl nicht verinnerlicht. Auch so
ein Gesetz, dass unserer Alltagserfahrung widerspricht.
Ich finde auf die Schnelle: https://de.wikipedia.org/wiki/Gesetz_der_gro
ßen_Zahlen
Wobei soll mir dass denn hier helfen?
Der Horizont verengt sich im Leben auf die Dauer immer mehr. Man sollte da
immer mal wieder gegensteuern.
Ja
Ich schrieb: Ich gebe ein Beispiel, welche Fehler man sich einhandelt, wenn
man zu früh rundet: X1 = 1. X2 = 1.232
( X2 - X1 ) * 1000
ergibt 1 wenn ungerundet
0 wenn auf 2 Stellen gerundet.
Das ist jetzt ein Trivialbeispiel.
Du schreibst: "Ja, und es ist bei Sporenmessungungen auch egal. Wir sind
hier in der Biologie."
Wenn Du Berechnungen mit Messwerten anstellst, ist es egal, was Du da
gemessen hast, oder für welchen Wissenschaftszweig Du die Rechnungen
anstellst, Du musst die numerische Stabilität prüfen.
Ich kann noch ein paar Sporen mehr vermessen und dann schauen, wie sich der Mittelwert verändert oder was meinst du genau?
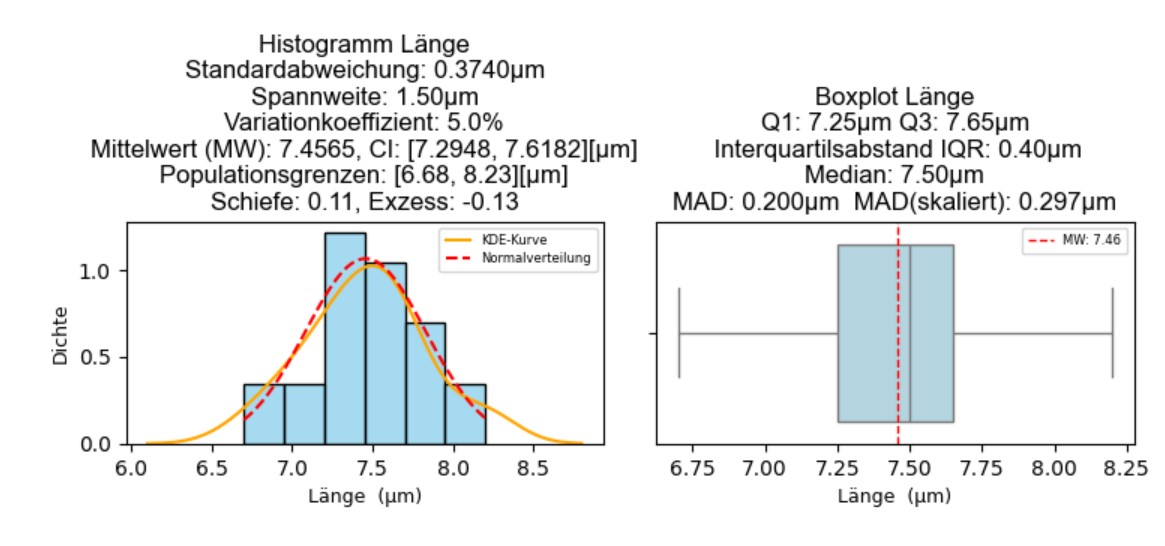
Ich hab doch die Grafik mit der Bootstrap-Methode gezeigt. Die tut so, als sei die Stichprobe die Grundgesamtheit und resampelt beliebig viele Stichproben aus der Stichprobe. Also mit zurücklegen.
Auf der rechten Seite der Grafik habe ich extra die Werte für Mittelwert und Populationsgrenzen, die dabei berechnet werden, mit angegeben.
Ich war sehr überrascht, dass die Ergebnisse derart ähnlich mit denen der Berechnung auf Normalverteilungsannahme waren.
Hier habe ich methodisch eine Alternative.
Und natürlich wird bei mir erst am Schluß gerundet, falls du da etwas falsch verstanden haben solltest.
Du schreibst: "Keiner will supergenaue Zahlen lesen, weil die
Unterschiede zwischen Sporenmessreihen und deren Streuung um den
Mittelwert größer sein kann, als man mit Nachkommastellen über 2 anzeigen
sollte.
Das bedeutet ja nicht, dass man nicht größerer Genauigkeit rechnet. Die
Publikation und die Berechnung bleiben zwei paar Schuhe."
Ich habe Dir mit einem Beispiel das Problem der numerischen Stabilität
erläutert, was hat dein Text damit zu tun?
Das bedeutet, dass die numerische Stbilität bei z.B. der Berechnungen aus 30 Sporen völlig egal ist. Wo tritt denn der Rundungsfehler bei 64bit Zahlen auf? An der ca. sechzehnten oder siebzehnten Stelle nach dem Komma. Da müsste ich viel mehr Berechnungen durchführen, damit das hier jemals zum Problem wird.
Theoretisch könnte ich ja 32bit Gleitkommazahlenberechnungen machen und mir den Unterschied anschauen. Mach ich aber nicht, weil dafür jede logische Grundlage bei so wenig Berechnungen fehlt.
Ich schrieb: Es gibt aber leider auch so etwas ähnliches wie eine Rundung,
wenn man eine Gleitkommazahl im Computer speichert. Es wird nie der
tatsächliche Wert gespeichert, sondern der Wert aus dem Wertevorrat, der
ihm am nächsten ist.
Python hat 64Bit Gleitkommazahlen. Das ist zwar recht genau, aber auch damit
kann man in das Problem laufen, dass ein korrekter Algorithmus aus Gründen
der numerischen Mathematik völlig falsche Ergebnisse liefert.
Du schreibst: "Aber nicht hier! Da müsstest du dich mit Martin im
Nachbarthread und der Unschärfetheorie auseinandersetzen Da bist in den
Nachkommastellen"
Du solltest anstatt solche sachfremde Bemerkungen zu machen, versuchen das
Problem der numerischen Stabilität zu verstehen.
Das Problem spielt hier keine Rolle.
Man findet zahlreiche Quellen, ob im Internet oder in der Literatur, mit
denen man sich einarbeiten kann. Zum Beispiel:
https://www.mat.tuhh.de/lehre/material/NMeth_2010.pdf
Du schreibst: "Genau, immer eine PROBE machen. Ich nenne das hier
StichPROBE."
Bitte begründe, was ein Stichprobe mit eine Probe zu tun hat, die die
numerische Stabilität prüft.
Nix. Aber ich mach die von dir angedachte Probe nicht. Wenn ich gegen unendlich viele Berechnungen dürchführen müßte, dann wäre es sinnvoll. Aber das passiert hier nicht und meine Variablen werden immer wieder neu initialisiert. Da kann nirgendwo ein Fehler durch zu viele Berechnungen auflaufen.
Ich schrieb: "Wie oben gezeigt sind insbesondere Differenzen von fast
gleichen Werten gefährlich. Man sollte das immer im Auge behalten.
Ja
Der Varianzschätzer verwendet zum Beispiel eine Differenz."
Du schreibst: "Die Unterschiede spielen hier keine Rolle. Es werden
Hypothesentests (auch mit der Varianz) auch bei nicht vorhandender
Normalverteilung durchgeführt. Dazu wird immer wieder geschrieben, dass
die Hyphothesentests relativ robust auf nur annähernde Normalverteilung
reagieren."
Ich beschreibe das Problem der numerischen Stabilität für deine Anwendung. Du
verstehst das überhaupt nicht. Hypothesentests sind Rechnungen und da hast
Du die numerische Stabilität zu beachten.
Siehe die Begründung oben.
Ich schrieb: "Deine Grafik zeigt übrigens deutliche Ähnlichkeiten der
statistischen Merkmale mit anderen Grafiken, die ich gesehen habe, die
Sporenmessungen wiedergeben."
Du schreibst: "So viele Möglichkeiten gibt es da ja nicht".
Es gibt unendlich viele Möglichkeiten, wie die Grundgesamtheit verteilt sein
kann.
Ich bezog mich auf die grafischen Möglichkeiten der Darstellung, nicht der darin enthalten Daten.
Als ersten Versuch würde ich prüfen, ob man die gefundene Verteilung nicht
transformieren kann, um sie ähnlicher zur Normalverteilung zu machen.
Hier finde ich auf die Schnelle etwas:
https://statistikguru.de/spss/vorraussetzungen-ueberpruefen/daten-transformieren/bekann...
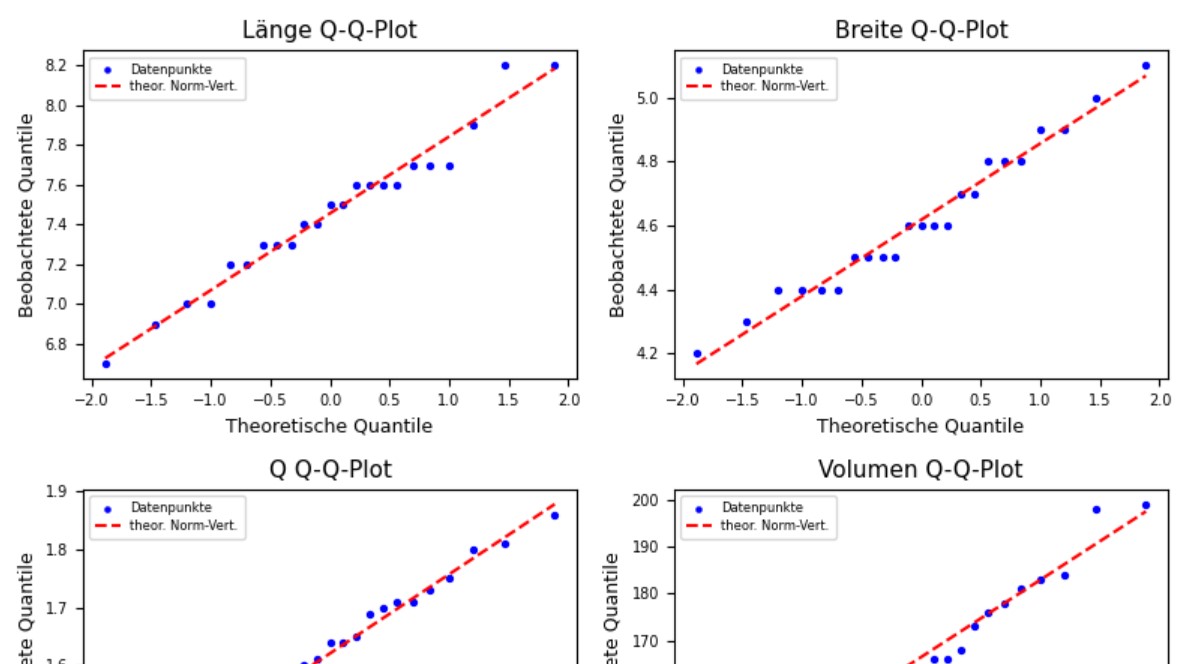
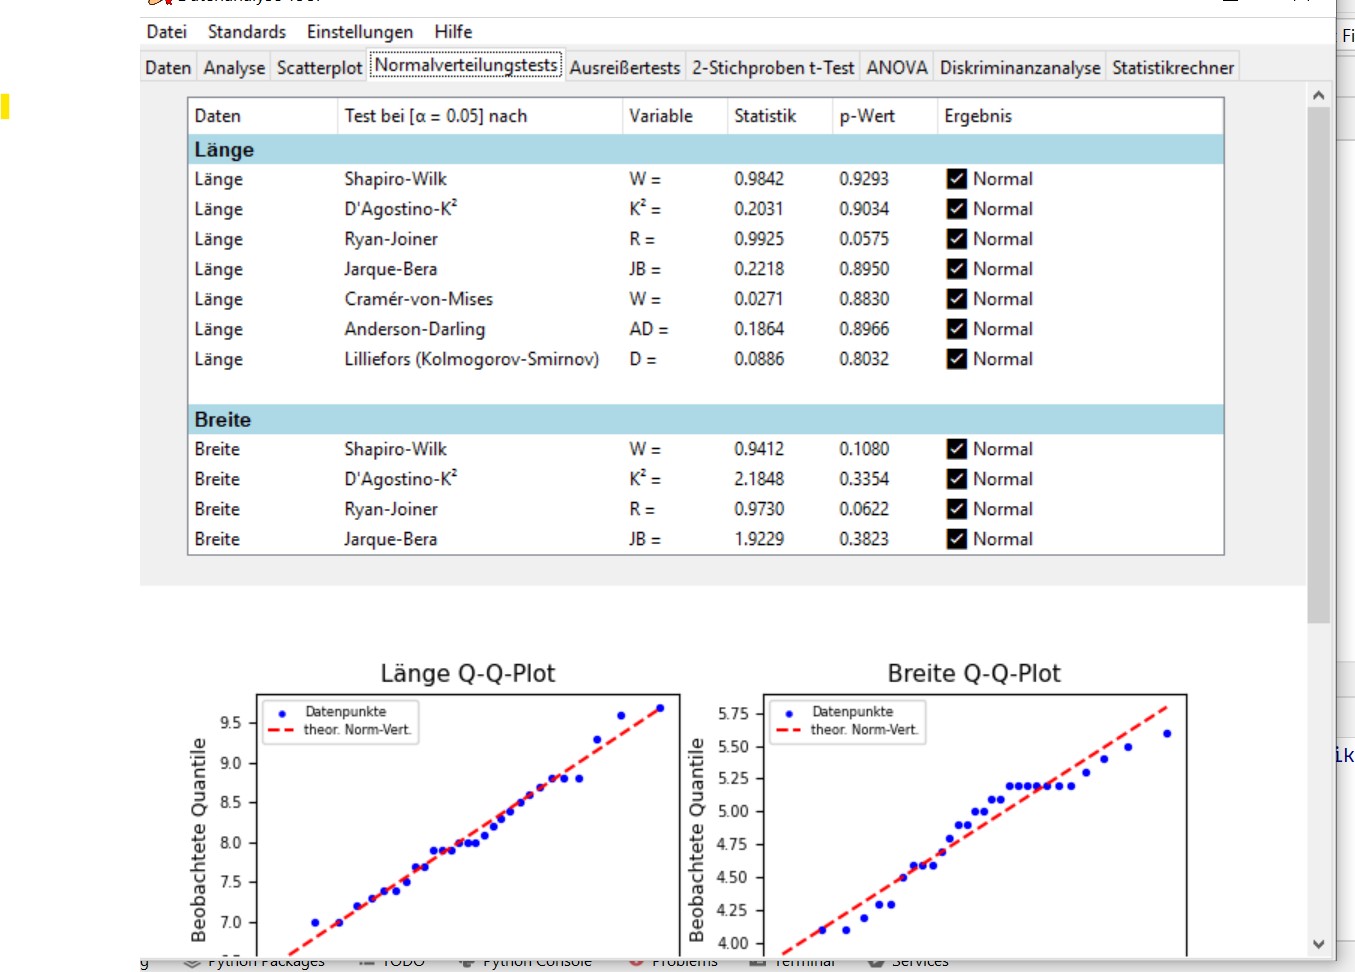
Wenn die Normalverteilungstests die Normalverteilung nicht ausschließen, wieso sollte ich dann noch transformieren? Im Programm zeigen Q-Q-Plots die Nähe oder eben nicht zur Normalverteilung auch noch einmal visuell. Hänge ich mal an.
Der zweite Versuch wäre es die höheren Momente zu schätzen und in der Theorie
bekannte Verteilungen zu finden, die dieselben haben.
Ja, die Normalverteilungsmomente beschreiben die Daten hier ganz gut. Das ist aber keine Selbstverständlichkeit. Und zustätzlich Schiefe und Exsess gebe ich doch auch an. Was willst du mehr?
Du schreibst: "Und es geht auch immer um Vergleichbarkeit."
Die hat man, wenn man die Verteilung genügend genau beschrieben hat.
Wenn man zum Beispiel feststellt, dass man für alle Stichproben die
Ähnlichkeit zur Normalverteilung durch die gleiche Transformation
verbessern kann, ist man weiter.
Ist aber wohl nicht nötig. Clemencon schreibt im verlinkten Papier, dass er sogar den Normalverteilungstest für unnötig hält, da bereits 87% seiner Stichproben normalverteilt seien und man somit einfach von einer Normalverteilung der Grundgesamtheit ausgehen könne.
Du schreibst: "Über Ausreißertests! Sind nur Theorien, aber nicht
widerlegte..."
Die von Dir verwendeten Tests setzen Normalverteilung voraus. Ich habe einen
parameterfreien Schätzer benannt, der braucht aber n > 60. Das sollte
einem zu Denken geben.
Ich weiß jetzt leider nicht mehr, welchen du benannt hast. Median vielleicht, der braucht aber keine n > 60?
Gebe ich ja mit an. Hatte ich auch schon drauf hingewiesen. Findest du in den Grafiken, die ich zeige.
Ich zitiere zum Thema Ausreißer folgende Seite:
https://de.wikipedia.org/wiki/Ausrei ßer
"Liegt ein Ausreißer vor, muss überprüft werden ob es sich bei dem
Ausreißer tatsächlich um ein verlässliches und echtes Ergebnis handelt
oder ob ein Messfehler vorliegt."
Ja, oder Fremdspore, mehrkernige Spore, Mutation, Fehler bei der Eingabe
Auf die Sporen übertragen: Man müsste jede Messung nachvollziehbar machen, um
dieselbe Spore erneut messen zu können.
Dann könnte man prüfen, ob sich Anhaltspunkte ergeben, dass ein Messfehler
vorliegt. Das könnte zum Beispiel durch eine Fremdspore passieren, die man
zum Beispiel durch Betrachten des Ornaments identifizieren könnte.
Dazu kann ich aber keinerlei Erfahrungen beisteuern.
Ja, wenn der Unterschied so simpel erkennbar wäre.
Du schreibst: ""unzureichende Ergebnisse" bringt er für was?
Da fehlt mir der Bezug."
Ich empfinde die Ergebnisse als unzureichend, wenn in der Stichprobe, die Du
auswertest, Werte enthalten sind, die nicht in dem von Dir berechneten
Konfidenzintervall liegen. Bei solchen winzigen Stichprobe, sollte das
nicht passieren.
n ist 30. Wie erkennst du da Werte? Ich sehe im Boxplot einen Wert ausserhalb des 1,5 fachen Interquartilsabstandes. Der wäre auch ohne Verteilungsannahme als Ausreißer anzusehen.
Du schreibst: "Aber was auch immer du da sagen willst, würde mich
interessieren, was du stattdessen angeben würdest?"
Ich würde Min Max Intervalle deiner Stichprobe angeben. Die kann man dann
auch leichter mit anderen Stichproben zusammenfassen.
Damit hättest du als einziges die Spannweite angegeben und hättest keine Möglichkeit, die Stichprobe mit anderen zu vergleichen. Wissenschaftlich gesehen eine Katastrophe! Und noch schlimmer, je mehr du misst, desto wahrscheinlicher sind Werte aus den Randbereichen dabei. Deine Spannweite würde immer größer werden. Du würdest also durch Erhöhung der Stichprobengröße immer ungenauer werden. Genau das will ich nicht. Mittelwertbasierte Tests wären nicht mehr möglich. ANOVA auch nicht.
Du schreibst: "Ich rechne die Ausreisser unter Normalverteilungsannahme.
Ich versuche damit soviel Power wie möglich in erste Ergebnisse zu
bringen."
Wenn Du Ausreißer herausnimmst, von denen Du nicht sicher weißt, dass sie
welche sind, reduziert Du die Aussagekraft deiner Angaben.
Es ist üblich, im Text darauf hinzuweisen, dass Ausreißer nicht mit berechnet wurden. Die Aussagekraft kann präziser werden, weil ich jetzt eine geringere Verschiebung der statischen Kennwerte mehr habe. Und ja, das Mittelwertkonfidenzintervall wird durch kleineres n größer.
Wenn ich vergleichbare Datensätze haben möchte, komme ich um Ausreissertests nicht herum.
Du schreibst: "Ja, und nach vielen Jahren eigener
Erfahrungsammlung"
Für das Messen von je ca. 60 Sporen für 10 Arten brauche ich nicht so lange.
Wenn ich mir ein Programm schreibe, das das macht, kann ich später
beliebige Sporenbilder auswerten.
Du hast vermutlich noch nie Sporen mit dem Mikroskop vermessen. Natürlich benötigt man für 60 Sporen x 10 Arten keine Jahre.
Wenn das so einfach wäre, hätte ich das Programm schon lange geschrieben. Ich hatte doch schon auf ein Beispiel mit ML hingewiesen und extra darauf hingewiesen, dass die Sporen dort rund waren. Zudem haben sie Sporen mittels Ultraschall auf eine Ebene gebracht
Bei uns schwimmen sie mehr oder weniger frei herum und man darf halt nur Sporen messen, die exakt flach in der Fokusebene schwimmen.
"liest du dir dann unseren Thread noch einmal durch und du wirst dich
fragen, wieso du so viel in Frage gestellt hast?"
Die Wahrscheinlichkeit dafür ist gleich 0. Dafür machst Du einfach zu viele
methodische Fehler. So hast Du erklärt, dass Du das Zusammenfassen von
Stichproben aus verschiedenen Quellen für nicht sinnvoll hältst.
Hab ich nicht. Warum auch? Genau dass wäre doch super. Ich habe darauf hingewiesen, dass es für den Vorgang statistische Methoden gibt.
Ohne Papier braucht man ein Grafikprogramm, mit dem man vermessen und bemaßen
kann. Sind schweineteuer und unangenehm zu bedienen: Auf Papier geht es
schneller eine Spore mit einem guten Längenmesser zu messen.
Schneller niemals. Und ich vermeide Eintippfehler bei der Zahleneingabe. ImageJ ist z.B. kostenlos. Oder Piximetrie. Ist auch kostenlos glaube ich.
Du schreibst: "Oder wann erkennst du an, das es einen Unterschied
zwischen endlicher und unendlicher Grundgesamtheit gibt?"
Du hattest erklärt, dass Du mit Theorie für eine endliche Grundgesamtheit
arbeitest.
Ich hatte Dich darauf hingewiesen, dass Du eine unendliche Grundgesamtheit
hast, weil Du Gleitkommazahlen verwendest.
Ich schrieb schon einmal, wenn der Pilz eine Million Sporen aussport, dann ist das eine endlich Grundgesamtheit. Das hat doch mit der späteren Berechnung nichts zu tun. Wohl aber mit der verwendeten Statistik. Und ich könnte auch mit Integerzahlen rechnen und das würde nichts am Ergebnis ändern.
Gruß, Jens