Pilze Pilze Forum
Erweitert
Suchen nach

Ein rel. wenig kartierter Pilz

Gelbfieber, (vor 495 Tagen)

Hallo und guten Tag,

wie in der Überschrift schon angekündigt zeige ich euch heute einen rel. wenig kartierten Pilz bzw. Pilzchen.
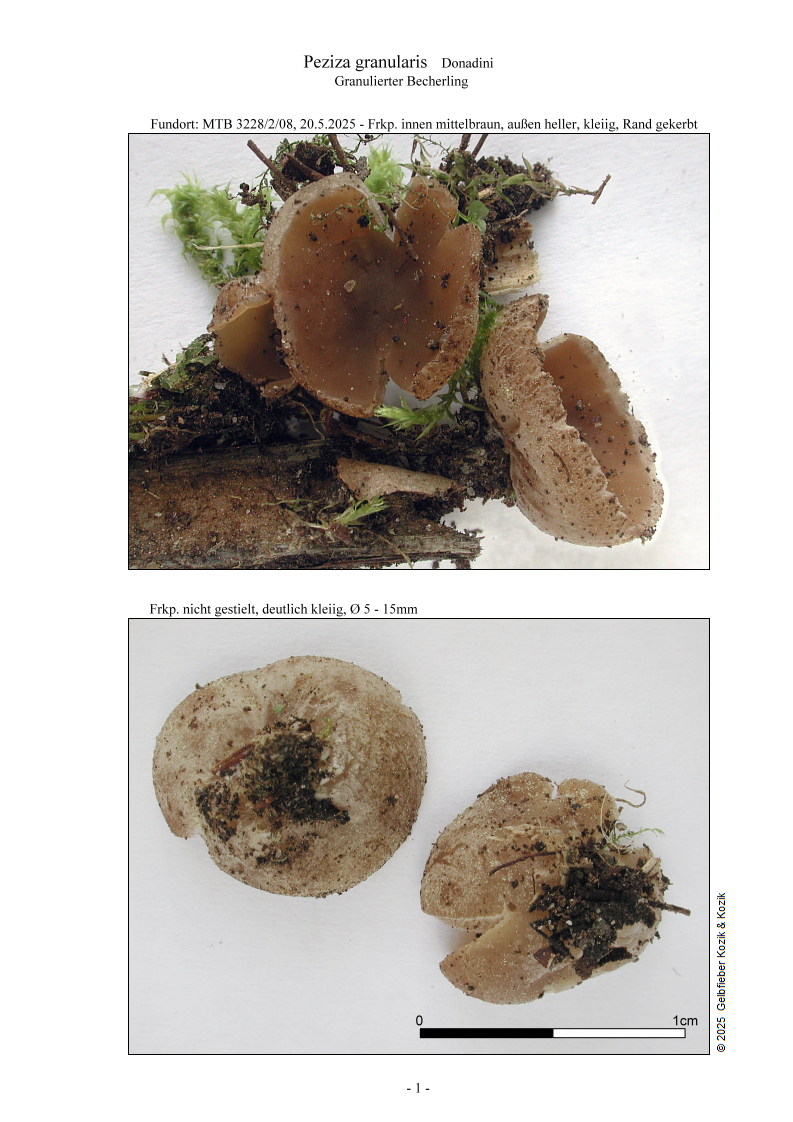
Dieses Pilzchen, ein Ascomycet, ist becherförmig, ungestielt, die Fruchtschicht ist mittelbraun, außen heller und kleiig, mit braunen Stippen, Rand gekerbt und gerade mal
5 – 15mm im Durchmesser.
Mikroskopisch hat das Pilzchen folgende Merkmale:
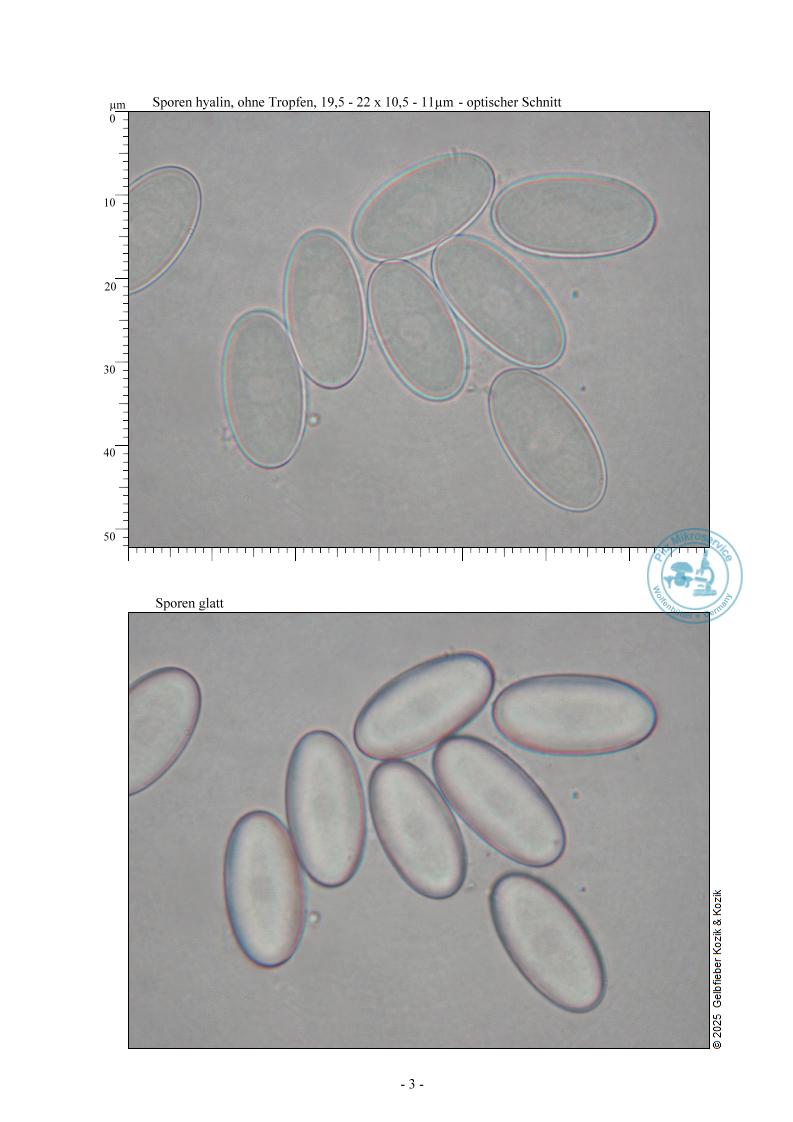
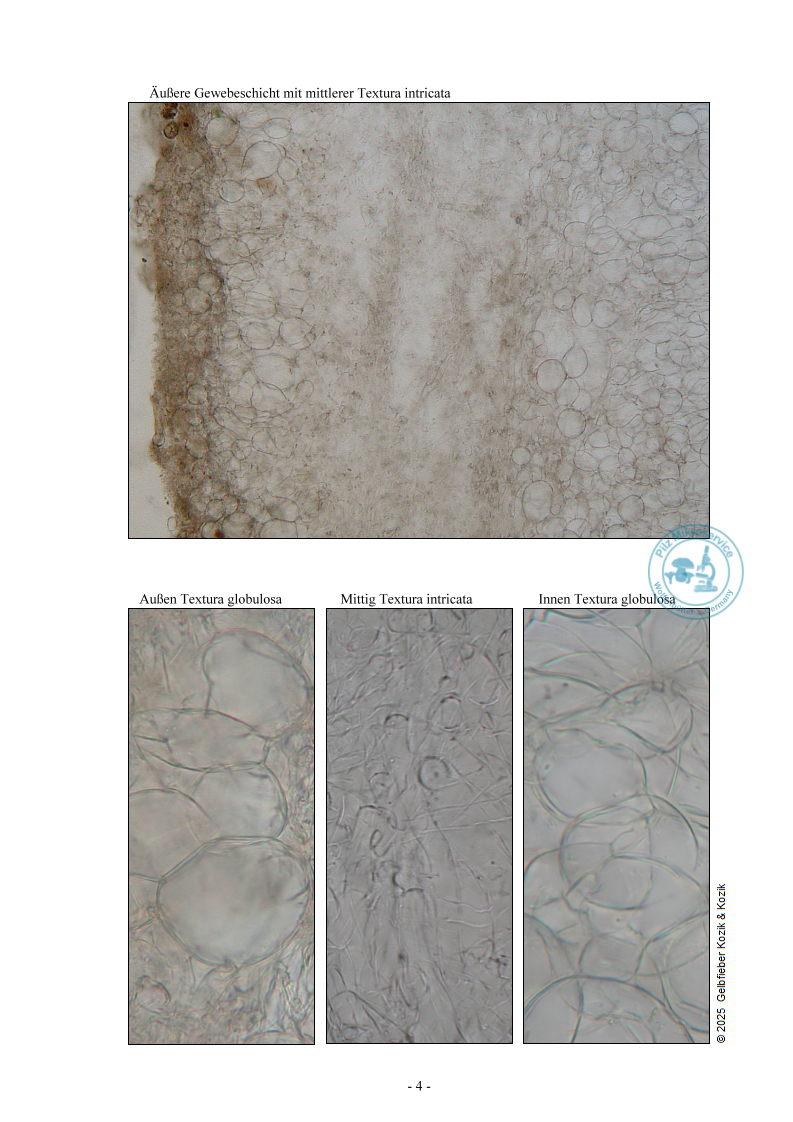
Sporen hyalin, glatt, ohne Tropfen, 19,5 – 22 x 10,5 – 11µm. Sporen im Ascus mit Gelhülle. Gewebeschicht mit mittlerer Textura intricata. Asci J+, achtsporig, Basis mit Haken. Die Paraphysen sind gerade, oben leicht kopfig, teilweise nicht gebogen, sondern geneigt. Auch moniliforme Paraphysen konnte ich sehen.
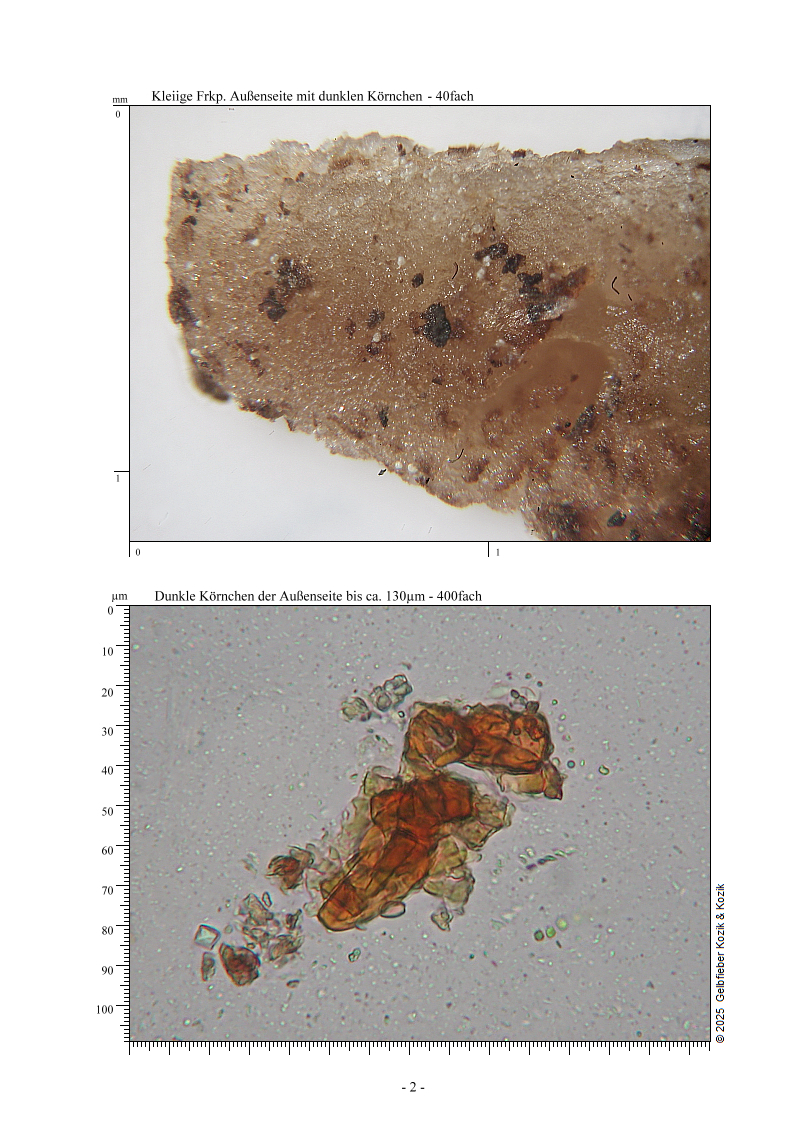
Bemerkenswert finde ich noch die kleinen braunen Stippen (Exsudat ?) auf der hellen kleiigen Außenseite. Sie sind mikroskopisch betrachtet, bernsteinfarbig und kristallartig.
Der Fundort ist ein grasiger Wegrand, Sandboden, Laub/Nadelwald, Mai 2025.
Jetzt fehlt noch der Name …..

Peziza granularis - Granulierter Becherling

Bestimmt nach H. Hohmeyer. Nun folgen die Bilder des winzigen Becherlings.

Eine gute Zeit
Gelbfieber & Co

[image]

[image]

[image]

[image]

[image]

Re: Ein rel. wenig kartierter Pilz

Axel Schilling ⌂, (vor 494 Tagen) @ Gelbfieber

Hallo Uschi,
wie du schon geschrieben hast ist dieses Pilzchen vor dir erst wenige Male, genau sechmal in Niedersachsen, gefunden und kartiert worden, wobei dein Fund der nördlichste ist. Es scheint magere und basenreiche Böden zu bevorzugen. Knut Wöldecke hat die Art als "Potentiell gefährdet" 2014 auf die Rote Liste gesetzt.
Viele Grüße,
Axel

Re: Ein rel. wenig kartierter Pilz

Gelbfieber, (vor 494 Tagen) @ Axel Schilling

Hallo und guten Tag Axel,

um dieses kleine Pilzchen zu finden bedarf es schon Glück. Habe in der Nähe mal eine Lorchel gefunden und jetzt nachgeschaut, ob ich sie wiederentdecken kann. Die Lorchel habe ich nicht gefunden aber einen ca. 3mm kleinen Pilz mit Hut und Stiel und daneben die Becherlinge.
Du schreibst von 6 Funden P. granularis in Niedersachsen. In der Online Kartierung sehe ich nur 2 Eintragungen. Gibt es da eventuell eine Verwechslung P. granularis - P. granulosa?

Axel bleib gesund, eine gute Zeit und interessante Pilzfunde trotz Trockenheit.
Uschi

Re: Ein rel. wenig kartierter Pilz

Axel Schilling ⌂, (vor 494 Tagen) @ Gelbfieber

Hallo Uschi,
alle Meldungen betreffen schon P. granularis.
Pilzkartierung Online gibt es erst seit 2004, vorher gibt es einige Eintragungen von Klaus und Knut Wöldecke zu der Art. Auch später haben beide noch in ihre eigene Datenbank eingegeben, die ich im Zuge unserer Checkliste und der in Arbeit befindlichen neuen Roten Liste Niedersachsen mit ausgewertet habe.
Dir alles Gute und
viele Grüße,
Axel

Re: Ein rel. wenig kartierter Pilz

Krötenhocker, (vor 491 Tagen) @ Gelbfieber

Hallo Uschi,
würdest du mir deine Messreihen zu deinen Pilzen zur Verfügung stellen? Smaff speichert die immer als MesswerttabelleKomma.txt mit ab. Ich werde eine Datenbank anlegen, welche analog zu GenBank solche Datensätze vorhalten soll.
Diese soll genauso öffentlich zugänglich werden wie GenBank und co. Ich schreibe Smaff gerade neu, damit es auch unter Linux läuft. Ggf. auch unter OS x.
Schön wäre es also, schon mal ein paar Datensätze zu haben und nicht eine fast leere Datenbank anzubieten. Ein paar eigene Datensätze habe ich natürlich auch. Übrigens sind deine Angaben immer falsifizierbar, im Gegensatz zu denen in den meisten Publikationen. Damit entsprechen sie einem wissenschaflichen Standard, welcher komischerweise in der Regel in der Mykologie (weltweit?) immer noch ignoriert wird.
Ach ja, das neue Smaff wird eine direkte Anbindung an die Datenbank haben, aber auch offline funktionieren. Jedenfalls habe ich es so geplant.

LG, Jens

Re: Ein rel. wenig kartierter Pilz

coco, (vor 488 Tagen) @ Krötenhocker

Hallo Jens,

das ist ja ein wunderbarer Ansatz. Dein smaff hat mir und vielen vielen anderen (wie auch Makroaufmassprogramm) sehr viel gegeben, unentgeltlich und aus reiner Menschen- und Naturliebe. Ich hab schon vor Jahren überlegt, ob man da irgendwas zurück- oder weitergeben könnte. Die Zahl meiner Messreihen sind überschaubar und hauptsächlich von Speisepilzen. Viel mehr Erfolg hätte ein kleiner Text in DGfM-Mitteilungen, Boletus, SPR, ÖZP und Tintling.
Oft habe ich versucht, in Mischungen falsch deklarierter Pilzpulver-Mischungen die beteiligten Arten zu quantifizieren, das ist sackschwer. Mithilfe von KI sollte es aber möglich sein, z.B. Konglomerate verschiedener Röhrlingssporen anhand von statistischen "Fehl-Mustern" in den LBQ-Quotienten besser zu quatifizieren. Wenn eine Datenbasis gegeben ist. Dann geht viel, z.B. auch eine klare Aussage über Schrumpfung von Sporen im Vergleich frisch / Exsikkat u.v.m.
Also: Super Initiative!

LG Coco

Re: Ein rel. wenig kartierter Pilz

Krötenhocker, (vor 486 Tagen) @ coco

Hallo Coco,

Ja, die Datenbasis ist das A und O! Ich habe hier diverse Clitopilus Messreihen, die mir Andreas G. mal zugeschickt hat, bin aber jetzt erst dazu gekommen, mir die Datensätze mal genauer anzusehen und es zeigt sich, dass erst über z.B. Mittelwertvergleiche qualifizierte Aussagen zu den Messreihen getroffen werden können. Auch weitere Analysen, wie ANOVA verlangen nach Rohdaten. Hinzu kommt, dass, wenn man weitere Möglichkeiten (KI, Diskrimanzanlyse, Tukey’s HSD) in Betracht zieht, man auch Vergleichsdaten benötigt. Jeder, der mit so einer statistischen Auswertung überfordert ist, kann dann zumindest seinen Datensatz zur allgemeinen Verfügung stellen oder um die Bearbeitung bitten. Clemencon schrieb mal, dass in seinen Basidiomycetensporendaten (ich glaube) 3-6 % abberate Sporen vorhanden wären. Und wenn es 10% wären.., die 3 Sporen von 30, die dann womöglich als Ausreißer erkannt werden, machen den Kohl nicht fett, führen aber durch "nicht mit berechnen" bei mir meist dazu, dass eine Normalverteilung vorliegt. Und wenn es keine Normalverteilungen gibt, kann man auch Mittelwerte oder Mediane vergleichen, nur eben leider mit einer geringeren Teststärke oder schön englisch: power.
KI muß man leider erst mit vielen Daten trainieren. Da ich jetzt Smaff in Python programmiere stehen diese Möglichkeiten theoretisch aber zur Verfügung.
Ach ja, wenn sich deine Röhrlingssporen wie Konglomerate anfühlen, könnte das auch an Heterosporie liegen. Meine erste Idee wäre dann, so viele Sporen zu messen, dass man eine Mehrgipfeligkeit der Verteilung erkennen kann und dann in den "Tälern" die Daten zu trennen. Ich glaube, dass ist mit Signifikanztests möglich. Nach der Trennung würde man dann auf verschiedene Grundgesamtheiten testen und dann z.B. einkernige, zweikernige und vierkernige Sporen getrennt beschreiben. So oder so schätzt man immer auf die Grundgesamtheit. In obigem Beispiel wäre das "Konglomerat" eine Mischung aus drei Grundgesamtheiten, die es erst zu trennen gilt. Aber auch dafür, bräuchte man Daten. Leider kann ich keine Aussage treffen, wieviele Sporen dazu vermessen werden müssten.

LG; Jens

Re: Ein rel. wenig kartierter Pilz

Marcel Weymann, (vor 486 Tagen) @ Krötenhocker

Hallo lieber Jens,
zunächst einmal möchte ich Dir sagen, dass es eine verdienstvolle Arbeit ist, solche Programme zu schreiben.
Ich möchte weiterhin etwas zu meinem Hintergrund sagen:
Ich bin seit dem 1.1.2025 in Rente und habe vorher 36 Jahre als Softwareentwickler gearbeitet.
Zuletzt im Maschinenbau.

Ich habe damals die Diskussionen verfolgt, die zu deinem Forenausschluss geführt haben.
Du hattest damals die Meinung vertreten, dass man unbedingt bei der Erfassung der Daten wie folgt vorgehen soll:
Mittelwert und Streuung aus den Messwerten schätzen.
Danach so lange Ausreißer entfernen, bis die Tests auf Normalverteilung nicht mehr ergeben, dass es keine Normalverteilung ist.
Aus den verbliebenen Werten Streuung und Mittelwert schätzen und dann auf Basis der Normalverteilung mit diesen Kennwerten Konfidenzintervalle schätzen.
Wenn ich da etwas falsch verstanden habe, korrigiere mich bitte.

Das Problem an der Vorgehensweise ist, dass der Test auf Normalverteilung nur zeigen kann, dass eine Messgesamtheit nicht der Normalverteilung folgt.
Wenn der Test nicht fehlschlägt, ist damit in keiner Art und Weise bewiesen, dass eine Normalverteilung vorliegt.

Der Test prüft nur folgendes:
Liegen Messwerte außerhalb Mittelwert Plus/Minus 3 mal Streuung
Um wirklich zu prüfen, ob Normalverteilung vorliegt, brauchst Du sehr viel mehr Werte.
Die Maschinen meines letzten Arbeitgebers produzierten unter Umständen in einer Schicht 10000 Teile.
Bei solchen Stückzahlen kann man anfangen, darunter braucht man das gar nicht zu versuchen.

In der Technik verwendet niemand die Normalverteilung für irgendwelche Vorhersagen zum Beispiel für den Prozentsatz von Teilen, die die Qualitätsvorgaben nicht erfüllen.
Das liegt daran,dass man in der Praxis niemals eine solche findet.

Eine Normalverteilung liegt nach Theorie dann vor, wenn es sehr viele ungefähr gleich starke Effekte gibt die zur Streuung der Messwerte beitragen.
Das gibt es in der Praxis nie.

Nehmen wir zum Beispiel das Standardbeispiel:
Sterbealter von Menschen in Deutschland.
Da wird gerne behauptet, das sei normalverteilt.
Ein flüchtiger Blick auf entsprechende Kurven zeigt, dass das Unfug ist.
Die Kurve ist schief. Selbst wenn man das transformiert, um die Schiefe wegzubringen, wird das keine Normalverteilung.

Grund: Es gibt zwar einige verschiedene Effekte, die Einfluss haben.
Aber:
1. Es sind halt nicht sehr viele.
2. Sie haben einen unterschiedlich starken Einfluss.

Es gibt bei den Wirtschaftswissenschaftlern einen sektenähnlichen Ansatz der sich Six Sigma nennt.
Ich hatte dazu vor Jahren ein Buch erworben.
Darin fand ich unter anderem den Satz:
"Man wirke der Ansicht entgegen, dass es sich bei Six Sigma um eine Sekte handele."
Diesen Unfug wollte man bei meinem ehemaligen Arbeitgeber - einem internationalen Konzern - mit Gewalt durchdrücken.
Irgendwann haben die aber den Bereich, in dem ich gearbeitet habe, geschlossen.
Die wirtschaftlichen Zahlen in den Bereichen, für die wir gearbeitet haben, waren zu schlecht.

Für das was Du da anstrebst, müsste man Methoden haben, mit denen man n-höckrige Verteilungen schätzt.
Mir ist so etwas weder in meinem Studium, noch im Berufsleben untergekommen.
Ich forsche da mal ein wenig nach.

Gruß,
Marcel

Re: Ein rel. wenig kartierter Pilz

Krötenhocker, (vor 486 Tagen) @ Marcel Weymann

Hallo Marcel,

Ich habe damals die Diskussionen verfolgt, die zu deinem Forenausschluss
geführt haben."

Meinst du im Pilzforum.eu? Woanders wohl nicht?, oder ich habe es nicht mitbekommen? Dort herscht leider das Diktat der "Liebe", nicht der Vernunft!

Danach so lange Ausreißer entfernen, bis die Tests auf Normalverteilung nicht
mehr ergeben, dass es keine Normalverteilung ist."

Hatte ich nie geschrieben, Das war ein Ansatz von Wolfgang P:, welchen ich heutzutage gar nicht mehr so schlecht finde. Nur, der Nalimow Test sollte dafür keine Verwendung finden.

Das Problem an der Vorgehensweise ist, dass der Test auf Normalverteilung nur
zeigen kann, dass eine Messgesamtheit nicht der Normalverteilung folgt.
Wenn der Test nicht fehlschlägt, ist damit in keiner Art und Weise bewiesen,
dass eine Normalverteilung vorliegt.

Entschuldige bitte, aber beweisen kann man hier sowieso nichts. Es geht darum, Hypothesen mit einer gewissenen Wahrscheinlichkeit (i.d.R 95%) für einen Erkenntnisgewinn zur Verfügung zu stellen. Und ja, wenn der Test nicht fehlschlägt, gibt es eine etwa 5%-ige Wahrscheinlichkeit, dass der Haypothesentest daneben liegt. 5% und nicht mehr!

Der Test prüft nur folgendes: Liegen Messwerte außerhalb Mittelwert
Plus/Minus 3 mal Streuung

Das ist jetzt komplett unterstellt und zeigt, dass du Smaff nie benutzt oder verstanden hast. Es wird schon in der damaligen Version der etablierte Shapiro-Wilk-Test verwendet, um eine Normalverteilung nicht ablehnen zu müssen.

In der Technik verwendet niemand die Normalverteilung für irgendwelche
Vorhersagen zum Beispiel für den Prozentsatz von Teilen, die die
Qualitätsvorgaben nicht erfüllen.
Das liegt daran,dass man in der Praxis niemals eine solche findet.

Da bin ich aber froh, dass Gauss das nicht lesen muss und Gosset nicht aus der Praxis kam!
Das ist natürlich, wie mir gerne vorgeworfen wird, polemisch und sarkastisch und stimmt hier auch! Entschuldigung! Ich musste mich so oft mit diesen unhaltbaren Thesen herumärgern, dass ich dir jetzt eigentlich am liebsten nicht mehr weiter antworten würde. Habe ich jetzt aber, und lasse es so stehen.

Eine Normalverteilung liegt nach Theorie dann vor, wenn es sehr viele
ungefähr gleich starke Effekte gibt die zur Streuung der Messwerte
beitragen.

Das mit den "ungefähr gleich starken Effekten" halte ich für nicht haltbar. Und "sehr viele"? Warum ? Kann man dann nur 1 Million Äpfel vergleichen?

Das gibt es in der Praxis nie.

"nie" zur Normalverteilung ist wohl schon in der Theorie ziemlich unhaltbar!

Und zum Sterbealter: Man kann halt immer nur auf eine Grundgesamtheit testen. Ich weiss jetzt nicht, welche du meinst? Raucher, Frauen, Männer, Orteherkunft oder sonstwas. Aber allgemein das Sterbealter zu betrachten, hat so viele Faktoren, dass man das schon eingrenzen sollte, um Effekte zu erkennen.
Und, mit Normalverteilung wären die teststärksten Tests möglich! Es gibt genug Alternativen ohne so viel "power"

Für das was Du da anstrebst, müsste man Methoden haben, mit denen man
n-höckrige Verteilungen schätzt.
Mir ist so etwas weder in meinem Studium, noch im Berufsleben untergekommen.
Ich forsche da mal ein wenig nach.

Die Problematik ist mir wohlbekannt. Mit all ihren Nuancen. Du liest leider nicht sorgfältig genug. Ich hatte "dass in seinen Basidiomycetensporendaten (ich glaube) 3-6 % abberate Sporen vorhanden wären. Und wenn es 10% wären.., die 3 Sporen von 30, die dann womöglich als Ausreißer erkannt werden" ... geschrieben.

Das beinhaltet die "n-höckrige Verteilungen" im kleinen. Die erhält man auch über Fremdsporen oder Mutationen. Wenn man viele misst, kann man auch die "Randerscheinungen" erkennen. Aber um die geht es doch i.d.R. nicht, sondern um Vergleichbarkeit und Erkenntnisgewinn.

Zusammenfassend: deine Aussagen widersprechen fast grundsätzlich meiner Erfahrung, meinen Quellen, aus denen ich programmiere, und den Erkenntnissen aus Messreihen und deren Auswertungen.

Deine Behauptungen dürfen so nicht stehen bleiben ohne gegengecheckt werden zu könne!
Das bedeutet:
Lieber Marcel, von dir hätte ich gerne zitierbare Quellen zu deinen Behauptungen!

Liebe Grüße zurück

Re: Ein rel. wenig kartierter Pilz

Marcel Weymann, (vor 486 Tagen) @ Krötenhocker

Hallo Jens,
Du schreibst:
"Es wird schon in der damaligen Version der etablierte Shapiro-Wilk-Test verwendet, um eine Normalverteilung nicht ablehnen zu müssen."
Hier einiges von:
https://de.wikipedia.org/wiki/Shapiro-Wilk-Test
"Der Shapiro-Wilk-Test basiert demzufolge auf einer Varianzanalyse (ANOVA) der Stichprobe, was auch der Originaltitel der Veröffentlichung An Analysis of Variance Test for Normality (for complete samples) deutlich macht."
Das entspricht dem, das ich beschrieben hatte.
"Der Shapiro-Wilk-Test hat auch bei kleinem Stichprobenumfang n Unendlich gehen.
Wie hoch das n in der Praxis sein muss, hängt davon ab, wie schnell das konvergiert. Der Satz sagt nur aus, dass es irgendwann konvergiert.

Auf ja Quellen:
Ein Studium der Elektrotechnik an der TH Karlsruhe.
Bücher:
Lothar Litz: Wahrscheinlichkeitsrechnung für Ingenieure.
Sämliche Bücher von Otto Föllinger zur Systemtheorie und Regelungstechnik.
aber auch:
Darrel Huff: How to lie with statistics.
Ich habe zuletzt 15 Jahre bei einem Hersteller von Wäge- und Positioniersystemen
gearbeitet.
Die Kunden müssen dort allerlei Verordnungen und Vorschriften der EU einhalten.
Unter anderem die FPV - die Fertigpackungsverordnung.
Die Einhaltung müssen die Kunden auch beweisen können. Wie schön wäre es, wenn man einfach annehmen könnte, das ist ungefähr normalverteilt. Wir messen Mittelwert und Varianz und dann können wir sagen, das wir die FPV einhalten.
Man sieht aber schon bei flüchtigem Hinsehen, dass das nicht normal verteilt ist.
Grund: es gibt bei jedem Produkt nur eine handvoll Gründe für Abweichungen.
Zum Beispiel einer:
Die Korngröße eines Ausgangsprodukts ist etwas größer, weil da einer einen neuen Sack angeschlossen hat.
Oder da hat etwas Wasser gezogen.
Oder etwas ist ausgetrocknet, das hat jetzt gestaubt.
Oder ein Ausgangsprodukt ist natürlichen Ursprungs, zum Beispiel Käse und die Fütterung der Tiere hat sich geändert etc.
Oder das Produkt ist in Plastik eingeschweißt. Das Plastik wurde nicht gleichmäßig geschnitten.

Liebe Grüße,
Marcel

Re: Ein rel. wenig kartierter Pilz

Krötenhocker, (vor 485 Tagen) @ Marcel Weymann

Hallo Marcel,

https://de.wikipedia.org/wiki/Körpergröße
Man sieht auf den ersten Blick: Das ist nicht normal verteilt.

Woran machst du dass fest? Die zwei Kurven (Männer, Frauen) sehen für sich doch normalverteilt aus?

Schaue Dir bitte: https://de.wikipedia.org/wiki/Normalverteilung
an.

Ich halte Wiki auch für eine sehr gute Wissenszusammenstellung. Aber glaube mir, ich verstehe die Normalverteilung. ich habe im Studium für die Klausur die Formel integriert und damals in einen Sharp (ich glaube, der hieß 1402) Taschencomputer programmiert. Der Prof sagte damals, wenn ich das programmieren kann, darf ich den auch verwenden, wenn ich keinen störe. Schnellste Klausur meines Lebens.

Und dann noch: https://de.wikipedia.org/wiki/Zentraler_Grenzwertsatz
Hier wird ein Grenzwert erzeugt. Das heißt da soll n-> Unendlich gehen.
Wie hoch das n in der Praxis sein muss, hängt davon ab, wie schnell das
konvergiert. Der Satz sagt nur aus, dass es irgendwann konvergiert.

Aber erklärt nicht genau dieser die Annäherung an die Normalverteilung?

Deine folgende Vita kann ich nur akzeptieren. Die Tests, die du da durchführen mußtest, waren doch in der Regel einseitig? Wieso du keine Normalverteilung erkennen konntest, entzieht sich meiner Vorstellungsmöglichkeiten. Gerade in der Produktion hat man doch tolle zufällige +- Abweichungen.

Auf Gosset bist leider nicht eingegangen. Da empfehle ich dir:
https://de.wikipedia.org/wiki/Studentsche_t-Verteilung
Da hat damals jemand Abweichungen von der Gauss Verteilung in der Praxis! erkannt. Deshalb rechnet man heutzutage bei kleineren Stichprobenumfängen mit der t-Verteilung.
Egal, ich möchte mich hier eigentlich nicht weiter über statistische Theorien mit dir auseinander setzen.
Wenn es Testprozeduren gibt, die nicht mehr in Frage gestellt werden, sollten wir davon auch Gebrauch machen.
Und noch ein Hinweis. T-Tests und ANOVA sind sehr robust, also auch wenn die Normalverteilung mal knapp abgelehnt werden sollte.

Oh, beim Querlesen habe ich jetzt noch einen Satz von dir gefunden, den ich überhaupt nicht nachvollziehen kann:

"Wenn die Verteilung nicht bekannt ist, sind keine solchen Aussagen möglich.
Also nimmt man an, das sei irgendwie halbwegs normalverteilt, um solche Aussagen machen zu können und gibt sicherheitshalber nicht an, dass man die Annahme Normalverteilung gemacht hat. "

Genau andersrum ist es doch richtig. Man nimmt die Normalverteilung an und muß sie g.g.f. hinterher ablehnen. Also etwas "sicherheitshalber nicht angeben" ist ein totales Nogo in der Statistik!

Liebe Grüße, Jens

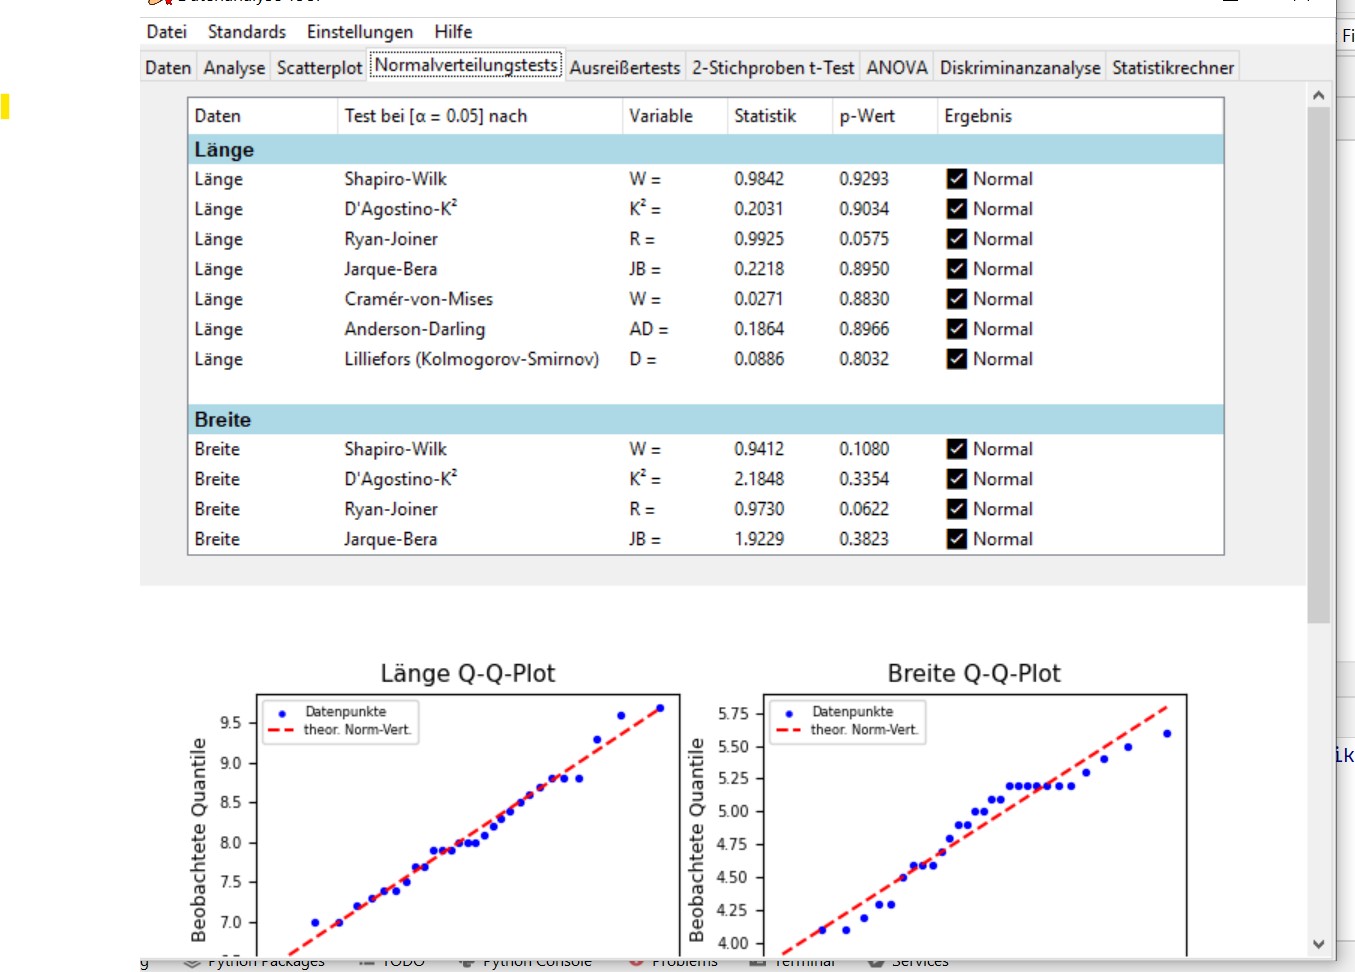
P.s.:Anbei eine Ansicht möglicher Normalverteilungstest in Smaff. In der Praxis sollte man sich auf einen festlegen.

[image]

Re: Ein rel. wenig kartierter Pilz

Marcel Weymann, (vor 484 Tagen) @ Krötenhocker

Hallo Jens,
Du schreibst:
"Genau andersrum ist es doch richtig. Man nimmt die Normalverteilung an und muß
sie g.g.f. hinterher ablehnen."
Das ist genau der zentrale Punkt in deinen Ausführungen, mit dem ich ein Problem habe.
Bitte benenne Quellen, die belegen, dass das eine zulässige Vorgehensweise ist.
Ich schrieb:
"Und dann noch: https://de.wikipedia.org/wiki/Zentraler_Grenzwertsatz
Hier wird ein Grenzwert erzeugt. Das heißt da soll n-> Unendlich gehen.
Wie hoch das n in der Praxis sein muss, hängt davon ab, wie schnell das
konvergiert. Der Satz sagt nur aus, dass es irgendwann konvergiert."
Du schreibst:
"Aber erklärt nicht genau dieser die Annäherung an die Normalverteilung? "
Der Satz erklärt nichts, er beschreibt, das für n-> Unendlich eine Annäherung an die Normalverteilung stattfindet.
Du hattest gefragt, warum denn n sehr groß sein muss, ich hatte das mit dem zentralen Grenzwertsatz begründet.
Du kannst das auch gerne mal selbst ausprobieren:
Die Summe von n Gleichverteilungen ergibt eine Binominalverteilung.
Für n -> Unendlich nähert sich die einer Normalverteilung an.
Programmier das mal, nimm als Beispiel n Mal würfeln. Ermittele die gemessenen Häufigkeiten.
Verwende einen geprüften Zufallszahlengenerator, bei Donald Knuth findet man welche.
Jeder kennt das von Würfelspielen:
Wie oft hat man den Eindruck, dass der Würfel nicht korrekt ist, weil zum Beispiel jemand 3 Mal hintereinander eine Sechs würfelt.
Man braucht sehr viele Würfe, um das zu überprüfen.
Du schreibst:
"Woran machst du dass fest? Die zwei Kurven (Männer, Frauen) sehen für sich
doch normalverteilt aus?"
Um mal polemisch zu werden: Die Gauss'sche Kurve wird als Glockenkurve bezeichnet.
Die Glocke würde ich nicht kaufen. Ich sehe sofort, dass die Kurve schief ist.
Leider haben die Mittelwert und Streuung nicht angegeben.
Die findet man anderswo:
Für Frauen:
Mittelwert 165,4 cm Streung: 4,5cm.
Wenn man sich nicht auf das Auge, sondern auf Berechnung verlässt, fällt sofort auf, auf dass der Mittelwert nicht mit dem Maximum zusammenfällt.
Das ist aber nicht das gröbste Problem.
5 Sigma wären 22,5cm.
Damit ist Mittelwert minus 4-5 Sigma 141,9-145,3 plus 4-5 Sigma 183,5-187,9
Bei Normalverteilung sollten nur 2.867865e-7 in einem der beiden Bereiche liegen.
Kaiserslautern hat ca. 100000 Einwohner.
Wenn ich durch die Stadt laufe, sehe ich alle Nase lang jemanden dessen Köpergröße erkennbar in diesem Bereich liegt.
Auch im Betrieb oder beim Sport treffe ich solche Menschen.
Das Hauptproblem bei der Normalverteilung ist, dass die Wahrscheinlichkeit zu schnell sinkt.
Das sieht man übrigens auch in der Graphik der Körpergrößen. Dazu braucht man aber etwas Erfahrung.
Ich finde Körpergrößen interessant, weil die ja die Folge eines Wachstumsprozesses ist, wie zum Beispiel auch die Sporengröße.
Jetzt komme ich noch zur Güte der statistischen Daten:
Da ist zunächst ein Mal der Nullpunkt abgeschnitten.
Eine der in "How to lie with statistics" benannten Methoden.
Das größere Problem ist aber folgendes:
Die Statistik wurde mit Hilfe freiwilliger Meldungen beim Mikrozensus erstellt.
Ein weiterer bekannter Trick: Diejenigen, die etwas angeben sind eine Auswahl, die einen "Bias" ergibt, einen systematischen Fehler.
Wer seine Größe als viel zu groß oder zu klein empfindet macht keine Meldung.
Ich war als Kind selbst ungewöhnlich klein, heute bin ich nur noch klein.
Ich litt darunter.
Ich kenne mehrere Leute, die als Erwachsene ungewöhnlich klein sind und die leider alle darunter und haben das wahrscheinlich nicht angegeben.
Jetzt übertrage ich das mal auf die Sporenmessung:
Was machst Du, wenn Du etwas findest, bei dem Du nicht sicher bist, ob das eine Spore der gesuchten Art ist?
Du hast da nur zwei schlechte Möglichkeiten.
Du misst nicht, dann machst Du einen Fehler, wenn das eine Spore der Art ist.
Du misst, dann machst Du einen Fehler, wenn es keine Spore der Art ist.
Man kann vermuten, dass das bevorzugte Vorgehen, von dem abhängt, der die Messung macht.
Wenn Du dann zum Beispiel geschätzte Mittelwerte und Streuungen aus Sporenmessungen verschiedener Menschen vergleichst, die dieselbe Art vor sich hatten, macht das ein Problem.
Du müsstest verschieden Menschen die gleichen Sporen messen lassen, um das abzuschätzen.

Ich habe noch etwas zu Herrn Gosset recherchiert:
William Sealy Gosset was an English statistician, chemist and brewer who worked for Guinness.
Gosset attended Winchester College before matriculating as Winchester Scholar in natural sciences and mathematics.
Er war also der Chefbrauer bei Guiness und hatte eine mathematische Ausbilung.
Als Techniker würde ich ihn nicht bezeichnen.
Da er wegen seines Arbeitgebers seine Ausführung nur anonym als "Student" veröffentlichen konnte, liegt folgendes nahe:
Er versuchte die Prozesse beim Brauen zu optimieren.
Die normale Vorgehensweise dabei ist:
Wir erstellen ein dynamisches Model des Prozesses, stellen Gleichungen auf und lassen die mathematischen Modelle darauf los.
Wie Otto Föllinger in seiner Optimierungsvorlesung erklärt hat, hat man aber manchmal kein gängiges mathematisches Modell.
Dann bleiben als letzte Rettung statistische Verfahren.
Gosset hatte dann noch mit dem Problem zu kämpfen, dass er nur kleine Stichprobenanzahlen hatte.
Leider gibt es für die Biologie nur sehr wenige gute mathematische Modelle.
Man sah das während Corona. Man hörte aller Orten von expotentiellem Wachstum.
Befragt Wissenschaftler fügten dann gerne noch hinzu:
"Gilt natürlich nur für eine begrenzte Zeit.
Deshalb können wir auch nur für einen begrenzten Zeitabschnitt Schätzungen abgeben."
Das einzige gute biologische Modell, das ich kenne, ist die Räuber - Beute Beziehung.
Tauchte auch bei Föllinger auf.
Herr Gosset wusste als guter Mathematiker, dass man nur etablierte Optimierungsansätze hat, wenn die Zufallsvariable normalverteilt ist.
Also prüfte er bei seinen Messreihen, ob etwas dagegen spricht, dass sie näherungsweise normalverteilt sind.
Wenn nein, verwendete er Optimierungsverfahren, die auf einer Normalverteilung beruhen.
Wie gut seine Ergebnisse waren, ist vermutlich Firmengeheimnis von Guiness.
Wie sagt aber ein Dozent auf der Uni in solchen Fällen: Besser ein dreckiger Hals als gar kein Hals.
Es ist also vollkommen in Ordnung, das zu versuchen.
Es ist aber nicht in Ordnung irgendwelche Wahrscheinlichkeiten zu benennen, wenn ich nicht sehr sicher bin, dass Normalverteilung vorliegt.
Dazu sollte man sehr viele Daten haben. Bei Sporenmessungen mit < 100 Messungen hat man die aber nicht.
Auch bei medizinischen Untersuchungen mit vielleicht 1000 Probanden kann man das nicht seriös machen.
Man kann Mittelwert und Streuung angeben oder Regressionsdiagramme zeigen, alles andere ist Kaffeesatzleserei.
Gruß,
Marcel

Normalverteilung

Krötenhocker, (vor 483 Tagen) @ Marcel Weymann

Hallo Maccel,

Du schreibst: "Genau andersrum ist es doch richtig. Man nimmt die
Normalverteilung an und muß
sie g.g.f. hinterher ablehnen."
Das ist genau der zentrale Punkt in deinen Ausführungen, mit dem ich ein
Problem habe.
Bitte benenne Quellen, die belegen, dass das eine zulässige Vorgehensweise
ist.

https://de.wikipedia.org/wiki/Shapiro-Wilk-Test
Getestet wird auf die Nullhypothese H0

Ich schrieb: "Und dann noch:
https://de.wikipedia.org/wiki/Zentraler_Grenzwertsatz
Hier wird ein Grenzwert erzeugt. Das heißt da soll n-> Unendlich gehen.
Wie hoch das n in der Praxis sein muss, hängt davon ab, wie schnell das
konvergiert. Der Satz sagt nur aus, dass es irgendwann konvergiert."
Du schreibst: "Aber erklärt nicht genau dieser die Annäherung an die
Normalverteilung? "
Der Satz erklärt nichts, er beschreibt, das für n-> Unendlich eine
Annäherung an die Normalverteilung stattfindet.
Du hattest gefragt, warum denn n sehr groß sein muss, ich hatte das mit dem
zentralen Grenzwertsatz begründet.
Du kannst das auch gerne mal selbst ausprobieren: Die Summe von n
Gleichverteilungen ergibt eine Binominalverteilung.
Für n -> Unendlich nähert sich die einer Normalverteilung an.
Programmier das mal, nimm als Beispiel n Mal würfeln. Ermittele die
gemessenen Häufigkeiten.
Verwende einen geprüften Zufallszahlengenerator, bei Donald Knuth findet man
welche.
Jeder kennt das von Würfelspielen: Wie oft hat man den Eindruck, dass der
Würfel nicht korrekt ist, weil zum Beispiel jemand 3 Mal hintereinander
eine Sechs würfelt.
Man braucht sehr viele Würfe, um das zu überprüfen.

Genau dafür hatte ich mal eine Excel-tabelle gemacht. Allerdings um zu zeigen, dass dann die Fläche unter der Kurve der Verteilung die Wahrscheinlichkeit ist.

Du schreibst: "Woran machst du dass fest? Die zwei Kurven (Männer,
Frauen) sehen für sich
doch normalverteilt aus?"
Um mal polemisch zu werden: Die Gauss'sche Kurve wird als Glockenkurve
bezeichnet.
Die Glocke würde ich nicht kaufen. Ich sehe sofort, dass die Kurve schief
ist.

Es wird doch auch nur von 'annähernd' normalverteilt geschrieben. Die mögliche leichte Schiefe ändert doch nichts an der Aussage. Übrigens ist diese in den Kurven in der später zitierten ourwoarldindata daten nicht mehr sichtbar, also für mich..

Leider haben die Mittelwert und Streuung nicht angegeben.
Die findet man anderswo: Für Frauen: Mittelwert 165,4 cm Streung: 4,5cm.
Wenn man sich nicht auf das Auge, sondern auf Berechnung verlässt, fällt
sofort auf, auf dass der Mittelwert nicht mit dem Maximum zusammenfällt.

Auf welche Grafik beziehst du dich? Die in Wiki: Körpergröße? Dort tut er es! Er verschiebt sich vielleicht um 0,irgenwas nach rechts. Das liegt meiner Meinung daran, dass man den Mittelwert nicht in den Plot integriert hat und womöglich eine leichte Schiefe vorliegt (Frauen).

5 Sigma wären 22,5cm.
Damit ist Mittelwert minus 4-5 Sigma 141,9-145,3 plus 4-5 Sigma 183,5-187,9
Bei Normalverteilung sollten nur 2.867865e-7 in einem der beiden Bereiche
liegen.
Kaiserslautern hat ca. 100000 Einwohner.
Wenn ich durch die Stadt laufe, sehe ich alle Nase lang jemanden dessen
Köpergröße erkennbar in diesem Bereich liegt.
Auch im Betrieb oder beim Sport treffe ich solche Menschen.
Das Hauptproblem bei der Normalverteilung ist, dass die Wahrscheinlichkeit zu
schnell sinkt.

Du solltest deine Quelle für die Daten gegenchecken! Sigma (Frauen) ist in Europa eher bei 7 cm. Ich komme damit für dein Intervall auf
130 - 137 ccm und nach oben auf 193 - 200 cm. Die Körpergrößen könnten auch in Kaiserslautern seltener sein...
Quelle: https://ourworldindata.org/human-height

Das sieht man übrigens auch in der Graphik der Körpergrößen. Dazu braucht man
aber etwas Erfahrung.
Ich finde Körpergrößen interessant, weil die ja die Folge eines
Wachstumsprozesses ist, wie zum Beispiel auch die Sporengröße.
Jetzt komme ich noch zur Güte der statistischen Daten: Da ist zunächst ein
Mal der Nullpunkt abgeschnitten.
Eine der in "How to lie with statistics" benannten Methoden.

Welchen Nullpunkt wo? Wenn du die Wiki-Seite meinst: Ist doch egal, es geht nicht um die Extreme.

Das größere Problem ist aber folgendes: Die Statistik wurde mit Hilfe
freiwilliger Meldungen beim Mikrozensus erstellt.
Ein weiterer bekannter Trick: Diejenigen, die etwas angeben sind eine
Auswahl, die einen "Bias" ergibt, einen systematischen Fehler.
Wer seine Größe als viel zu groß oder zu klein empfindet macht keine Meldung.
Ich war als Kind selbst ungewöhnlich klein, heute bin ich nur noch klein.
Ich litt darunter.
Ich kenne mehrere Leute, die als Erwachsene ungewöhnlich klein sind und die
leider alle darunter und haben das wahrscheinlich nicht angegeben.

Das ist nicht schön und deshalb haben wir Diskriminierungsstellen. Aber die Daten sind vom statistischen Bundesamt. Willst du deren Vorgehensweise in Frage stellen?

Jetzt übertrage ich das mal auf die Sporenmessung: Was machst Du, wenn Du
etwas findest, bei dem Du nicht sicher bist, ob das eine Spore der
gesuchten Art ist?
Du hast da nur zwei schlechte Möglichkeiten.
Du misst nicht, dann machst Du einen Fehler, wenn das eine Spore der Art ist.
Du misst, dann machst Du einen Fehler, wenn es keine Spore der Art ist.
Man kann vermuten, dass das bevorzugte Vorgehen, von dem abhängt, der die
Messung macht.

Um das Problem zu umgehen, habe ich schon lange vorgeschlagen, lieber am Bild zu messen und darin grundsätzlich alle richtig liegenden Sporen zu messen (Zufall), sofern sie nicht defekt, zu jung oder offensichtlich Fremdsporen sind.

Wenn Du dann zum Beispiel geschätzte Mittelwerte und Streuungen aus
Sporenmessungen verschiedener Menschen vergleichst, die dieselbe Art vor
sich hatten, macht das ein Problem.
Du müsstest verschieden Menschen die gleichen Sporen messen lassen, um das
abzuschätzen.

Ja, man könnte ein oder mehrere Standardbilder mit Sporen verschiedener Arten und Ausprägungen zur Verfügung stellen, welche von Experten vermessen wurden. An den Ergebnissen kann sich dann jeder selbst vergleichen. Natürlich darf auf den bereitgestellten Bildern dann die Vermessung nicht sichbar sein. Damit könnte man auch sytematische Fehler erkennen.

Ich habe noch etwas zu Herrn Gosset recherchiert: William Sealy Gosset was an
English statistician, chemist and brewer who worked for Guinness.
Gosset attended Winchester College before matriculating as Winchester Scholar
in natural sciences and mathematics.
Er war also der Chefbrauer bei Guiness und hatte eine mathematische
Ausbilung.
Als Techniker würde ich ihn nicht bezeichnen.
Da er wegen seines Arbeitgebers seine Ausführung nur anonym als
"Student" veröffentlichen konnte, liegt folgendes nahe: Er
versuchte die Prozesse beim Brauen zu optimieren.
Die normale Vorgehensweise dabei ist: Wir erstellen ein dynamisches Model des
Prozesses, stellen Gleichungen auf und lassen die mathematischen Modelle
darauf los.
Wie Otto Föllinger in seiner Optimierungsvorlesung erklärt hat, hat man aber
manchmal kein gängiges mathematisches Modell.
Dann bleiben als letzte Rettung statistische Verfahren.

Haben wir ein gängiges mathematisches Modell? Ich kenne keines. Was also bleibt nach Herrn Föllinger?

Herr Gosset wusste als guter Mathematiker, dass man nur etablierte
Optimierungsansätze hat, wenn die Zufallsvariable normalverteilt ist.

Jetzt streitest du die Normalverteilung nicht mehr ab?

Also prüfte er bei seinen Messreihen, ob etwas dagegen spricht, dass sie
näherungsweise normalverteilt sind.
Wenn nein, verwendete er Optimierungsverfahren, die auf einer
Normalverteilung beruhen.
Wie gut seine Ergebnisse waren, ist vermutlich Firmengeheimnis von Guiness.
Wie sagt aber ein Dozent auf der Uni in solchen Fällen: Besser ein dreckiger
Hals als gar kein Hals.
Es ist also vollkommen in Ordnung, das zu versuchen.
Es ist aber nicht in Ordnung irgendwelche Wahrscheinlichkeiten zu benennen,
wenn ich nicht sehr sicher bin, dass Normalverteilung vorliegt.

Wie du schon schriebst, sicher kann man sich nicht sein. Muß man auch gar nicht. Man kann die Normalverteilung halt nur nicht auf einen bestimmten Niveau ablehnen. Dass ist womöglich das, was geklärt werden muss?

Dazu sollte man sehr viele Daten haben. Bei Sporenmessungen mit < 100
Messungen hat man die aber nicht.

Für die letzte Aussage hätte ich gerne eine Quelle! Einige Ausreißertests funktionieren dann schon gar nicht mehr, wie ich es in Erinnerung habe.

Auch bei medizinischen Untersuchungen mit vielleicht 1000 Probanden kann man
das nicht seriös machen.

Darum geht es hier nicht! Es sind i.d.R. andere Methoden. Hier geht es um die Schätzung der Grundgesamtheit.

Man kann Mittelwert und Streuung angeben oder Regressionsdiagramme zeigen,
alles andere ist Kaffeesatzleserei.

Ja und Nein. Ja, am präzisesten ist Mittelwert und Streuung. Für die Angabe von Populationsgrenzen benötige ich dann aber noch ein Populationsniveau, auf dem ich die Grundgesamtheit schätze.

Nein, andere statistische Werte können uns Informationen über die Güte der Verteilung und ihrer Vergleichbarkeit mit anderen Stichproben liefern.

Es geht nicht nur um Normalverteilungsannahme oder nicht. Es geht um die Falsifizierbarkeit von veröffentlichten Daten und die Vergleichbarkeit mit und von Stichproben.

Was sind denn deine Vorschläge zu Berechnungen zu diesem Thema. Wie würdest du an das Thema herangehen? Also Stichprobenvergleiche, Datennotation und -doku-mentation in Erstbeschreibungen oder Dokumentationen?

Gruß zurück, Jens

Re: Normalverteilung

Marcel Weymann, (vor 479 Tagen) @ Krötenhocker

Hallo Jens,

Hallo Jens,
du schreibst:
"Jetzt streitest du die Normalverteilung nicht mehr ab?"
Die Normalverteilung ist ein mathematisches Modell.
Mathematische Modelle kann man nicht bestreiten.
Sie sind durch mathematische Operationen definiert.
Die geniale Erfindung Mathematik erlaubt es, in völlig verschiedenen Anwendungsbereichen zumindest versuchsweise die gleichen mathematischen Modelle zu verwenden.
Es ist völlig gleichgültig, ob das sich um das Messen von Pilzsporen, den Einfluss von Salz auf die Wahrscheinlichkeit des Sterbens an einer Herz- Kreislauferkrankung oder die Messung des Gewichtes einer Fertigverpackung handelt, die Mathematik bleibt gleich.
Leider findet man in der Praxis mathematische Modelle nie exakt wieder.
Mir ist kein Verfahren bekannt, mit dem man abschätzen kann, welchen Fehler man macht, wenn man annimmt, dass etwas normalverteilt ist und diese Annahme nicht stimmt.
Wenn man die tatsächlich vorhandene Verteilung kennt und die irgendwie auf etwas mathematisch Untersuchtes abbilden kann, kann man unter Umständen mathematisch berechnen, wie groß ein Fehler sein wird.
In manchen technischen Fällen gibt es bekannte Verteilungen, von denen man aus vielen praktischen Versuchen weiß, dass diese Verteilungen in guter Näherung angenommen werden.
Zum Beispiel die sogenannte "Badewannenverteilung" für die Ausfallwahrscheinlichkeit technischer Geräte.
(Heute wieder ein wichtiges Thema: Geplante Obsoleszenz)
Für die Normalverteilung, müsste man zunächst einmal ein Ähnlichkeitskriterium definieren.
Mir sind keine Versuche diesbezüglich bekannt.
Die angegebenen Tests machen folgendes:
Wenn der Test anschlägt sagt er mir, dass diese Größe mit n % Wahrscheinlichkeit nicht normal verteilt ist.
Was man aber bräuchte wäre eine Aussage wie: Die Ähnlichkeit dieser Verteilung zur Normalverteilung hat folgenden Ähnlichkeitsindex.
Dann bräuchte man noch eine mathematische Theorie, die mir sagt welchen Fehler ich mir damit einhandele.
Da Du all das nicht hast, musst Du Deine Berechnungen irgendwie prüfen.
Das ist ein allgemeines Problem in der Technik.
Zur Berechnung von dynamischen Bewegungen - Beispiel Bewegung eines Aufzugs - verwendet man Modelle, von denen man weiß, dass Sie nie vollständig in der Praxis auftreten.
In diesem Fall die lineare Theorie.
Darum kommt es entscheidend darauf an, für was man das Modell verwendet:
1. Man konstruiert ein Gerät zum Beispiel einen Aufzug. Man kann hinterher testen, ob der Aufzug korrekt funktioniert.
Wie ich leider anlässlich von Besuchen bei meiner 94 Jährigen Mutter im Krankenhaus feststellen musste, sind dazu auch renommierte Aufzugkonstrukteuere nicht in der Lage.
Ich musste mehrmals am Tag 7 Geschosse aufsteigen.

2. Der Prozess funktioniert, man hätte gerne, dass er noch besser funktioniert.
Das kann man auch testen, schon mühsamer.
Man muss eine ausreichende Anzahl Stichproben nehmen und weiß nicht wie viele denn ausreichend sind.

3. Man möchte Vorhersagen machen, mit welcher Wahrscheinlichkeit etwas passiert.
Wenn die Wahrscheinlichkeiten 1Unendlich.
Dummerweise findet man nirgendwo Aussagen, über die Streuung oder gar über die Wahrscheinlichkeitsverteilung.
Ich wusste folgendes:
Quicksort hat einen schlechtesten Fall. In diesem Fall ist die Komplexität n Quadrat.
Genau den schlechtesten Fall zu treffen ist zwar sehr unwahrscheinlich - es ist genau eine Anordnung aller Objekte - aber keiner beschreibt in der Theorie was bei Fällen passiert, bei denen die Anordnung in der Nähe des schlimmsten Falles liegt.
Ich habe dann Simulationen mit dem schlechtesten Fall ausgeführt und fand meine Vermutungen bestätigt.
Ich habe dann einen Algorithmus programmiert, der nicht nur im statistischen Mittel eine Komplexität von n log n hat, sondern in jedem Einzelfall.
Damit war der Fehler beseitigt.
Der schlechteste Fall bei "naiv" programmiertem Quicksort ist eine umgekehrt sortierte Liste.
Im konkreten Fall war folgendes passiert:
Menschen geben Listen nicht zufällig ein, sondern grob sortiert.
Diese Liste wurde dann an das Gerät übertragen.
Das Gerät verfuhr nach dem Prinzip:
Die Ersten werden die Letzten sein.
Oder informatisch: LIFO = Last in first out.
Der letzte der reinkommt, kommt als erstes wieder raus.
Damit entstand eine näherungsweise umgekehrt sortierte Liste.
Damit war der Aufwand für die Berechnung näherungsweise n Quadrat und die Übertragung brach deshalb ab.
Mittlerweile hat die Firma Winzigweich einen weniger naiven Quicksort Algorithmus in ihrer Bibliothek.
Der weniger naive Algorithmus verwendet einen Zufallsgenerator, um zu bestimmen, wo im "Teile und Herrsche" Algorithmus die Teile abgegrenzt werden.
Das löst zwar das Problem nicht wirklich, aber der Fall tritt in der Praxis seltener auf.
Man kann immer noch Anordnungen konstruieren, bei denen solche Probleme entstehen.
Es ist nur für einen Menschen nicht mehr so einfach.
Quicksort gilt als der schnellste Sortieralgorithmus, aber nur im Mittel. In jedem Buch über Algorithmen findet man derartige Tests.
Wenn jemand irgendwelche zufällige Anordnungen konstruiert, gewinnt es immer.
Als Techniker muss ich aber garantieren, dass das in vorgegebener Zeit terminiert und das kann ich nicht.
Ich habe in meinem letzten Arbeitsverhältnis Echtzeitsysteme programmiert.
Das hieß in der Praxis, ich habe eine Toleranz von ca. 1 Millisekunde.
Wenn ich die nicht einhalte, breche ich Gesetze oder bringe die Anlage zum Stoppen, weil eine nachgelagerte Kontrolle anspricht.
Praktisch sieht das so aus:
Wenn meine Rechnung erst fertig wird, wenn das Objekt gerade da vorbei ist, wo es rausgeworfen werden sollte, gibt es ein Problem.
Gruß,
Marcel

Re: Normalverteilung

Krötenhocker, (vor 479 Tagen) @ Marcel Weymann

Hallo Marcel,

Es ist völlig gleichgültig, ob das sich um das Messen von Pilzsporen, den
Einfluss von Salz auf die Wahrscheinlichkeit des Sterbens an einer Herz-
Kreislauferkrankung oder die Messung des Gewichtes einer Fertigverpackung
handelt, die Mathematik bleibt gleich.

Meiner Meinung nach nicht. Bei der Verpackung wird gegen eine Toleranzvorgabe getestet. Noch einmal: Hier versuche ich, falsifizierbare Aussagen zur Grundgesamt zu treffen und diese auch so publifizierbar vorzuhalten. Diese Grundgesamtheit ist endlich. Die Daten in deinen Beispiele nicht. Also ganz andere Statistik.

Leider findet man in der Praxis mathematische Modelle nie exakt wieder.
Mir ist kein Verfahren bekannt, mit dem man abschätzen kann, welchen Fehler
man macht, wenn man annimmt, dass etwas normalverteilt ist und diese
Annahme nicht stimmt.

Wenn ich mit 95%iger Wahrscheinlichkeit die Normalverteilung nicht ablehnen kann, bleiben 5% für deinen oben beschriebenen Fall, genannt Fehler 1. Art.

Wenn man die tatsächlich vorhandene Verteilung kennt und die irgendwie auf
etwas mathematisch Untersuchtes abbilden kann, kann man unter Umständen
mathematisch berechnen, wie groß ein Fehler sein wird.
In manchen technischen Fällen gibt es bekannte Verteilungen, von denen man
aus vielen praktischen Versuchen weiß, dass diese Verteilungen in guter
Näherung angenommen werden.

Wir sind hier in der Biostatistik und nicht bei Technik. Sonst würden wir wohl auch nur Mittelwert +- Sigma angeben.

Für die Normalverteilung, müsste man zunächst einmal ein
Ähnlichkeitskriterium definieren.
Mir sind keine Versuche diesbezüglich bekannt.

Irgendwie reden wir über unterschiedliche Ansätze. Ich rede über Hypothesentests, welche man für Verteilungsvergleich und Messreihenvergleiche rechnen kann. Entweder mit Normalverteilungsannahme oder ohne. Ohne haben die Tests halt weniger Power.

Die angegebenen Tests machen folgendes: Wenn der Test anschlägt sagt er mir,
dass diese Größe mit n % Wahrscheinlichkeit nicht normal verteilt ist.
Was man aber bräuchte wäre eine Aussage wie: Die Ähnlichkeit dieser
Verteilung zur Normalverteilung hat folgenden Ähnlichkeitsindex.

Ja, nennt man p-Wert. Die Tests haben i.d.R. eigene Statistiken, welche man aber über den p-Wert normieren kann. Ich hatte doch irgendwo Bilder angehängt. Da ist der Eigenstatistikwert und der p-Wert zu sehen.

Dann bräuchte man noch eine mathematische Theorie, die mir sagt welchen
Fehler ich mir damit einhandele.

Da ich die Wahrscheinlichkeit selber aussuche, gebe ich auch den Fehler selber an.

Zu deinen weiteren Ausführungen muß ich leider sagen, dass sie von der Diskussion ablenken. Hier sollte es um Sporenmessungen und eine zukünftige Datenbank mit Messungen gehen. Wenn man die Rohdaten vorhält, sind jederzeit Änderungen an den Methoden möglich. Aber eben auch neue Ansätze, wie Coco schon schrieb, um z.B. Schrumpfungsprozesse durch Lagerung zu untersuchen.
Mir geht es hier z.B. um Anova, Diskrimanzanlyse (hier LDA) und um Erkenntnisse, in wie weit und in welcher Form man die Vergleichbarkeit von Messreihen bei Pilzsporen verbessern kann.
Es werden immer mehr Arten phylogenetisch beschrieben, welche aber taxonomisch schlecht trennbar sind. Dabei könnte so eine Datenbank helfen. Aber vor allem hoffe ich, dass die Daten bei Messungen an Sporen fasifizierbar beschrieben werden. Dass ist in der Regel weltweit nicht der Fall. Ein löbliches Beispiel ist hier die Website von Jürgen Marqua: http://www.pilzflora-ehingen.de/
Aus diesen Werten kann ich für Vergleiche Sigma zurückrechnen. Nichts ist so schlecht in der Aussage (ohne weitere Angaben), wie 8-10 µm.

Gruß, Jens

Re: Normalverteilung

Marcel Weymann, (vor 477 Tagen) @ Krötenhocker

Hallo Jens,
"Litz: Wahrscheinlichkeitstheorie für Ingenieure"
gibt einen erwartungstreuen Konfidenzintervallschätzer für Normalverteilung an.
Erwartungstreu heiß, dass für n->Unendlich der tatsächliche Wert erreicht wird.
Es gibt keine Angabe darüber, ab welchem n man wie nahe am Wert ist.
Weiterhin schreibt er
"Die Ausweitung des Ergebnisses auf den praxisrelevanten Fall eines Merkmals mit unbekannter Verteilung und unbekannter Varianz ist geradlinig,
Der unbekannten Verteilung begegnet man mit dem zentralen Grenzwertsatz, der besagt, dass für hinreichend gr0ßes n die Summe beliebig verteilter Zufallszahlen immer normalverteilt ist.
...
Die unbekannte Varianz bedeutet, dass wir in der Transformation die Standardabweichung durch die Wurzel aus s Quadrat ersetzen müssen.
Us = Xquer - Myx / ( S / Wurzel(n))
Wie .. gezeigt hat gehorcht Us der sogenannten Student Verteilung."
Student war das Pseudonym von Herrn Gosset.
Litz macht weder Angaben darüber, was denn hinreichend groß sein soll, noch Angaben darüber, wie gut die Näherung für das Konfidenzintervall ist, wenn die Verteilung nur näherungsweise eine Normalverteilung ist.
Das heißt, wenn Du mit deiner Methode Konfidenzintervalle bestimmst, ist das keine Messung, weil Du die Genauigkeit noch nicht einmal abschätzen kannst.
Damit ist deine Messeinrichtung nur ein sogenanntes Schätzeisen.
Mir ist kein Fall bekannt, bei dem jemand mit Hilfe so bestimmter Konfidenzintervalle Ziele, wie Du sie angibst, erreicht hat.
Kennst Du einen?
Wer darüber nachdenkt, so etwas zu verwenden, sollte es zuerst per Simulation testen.
Nachdem Du in der Vergangenheit für deine Methode damit geworben hast, dass das in der Technik jeder so mache, findest ich es befremdlich, dass Du nachdem ich Dir die Probleme deiner Vorgehensweise gezeigt habe,
die Aussage machst, in der Technik gelte eine andere Mathematik als in der Biologie.
Du verweist mehrfach auf die Ziele, die Du verfolgst, die ja andere seien als die in der Technik.
Die Mathematik interessiert sich nicht für die Ziele, die Du verfolgst.
Zunächst einmal hatte ich allgemein von der Messung des Gewichts gesprochen und FPV nur als Beispielanwendung angegeben.
Aber auch deine Behauptung, bei der FPV ginge es um die Einhaltung von Toleranzen, ist falsch.
Bei der FPV gibt es zum Beispiel auch eine Mittelwertforderung.
Da die Produzenten möglichst wenig wegschmeißen wollen, wird die Überwachung des Mittelwerts von fast allen Produzenten durchgeführt.
Die schätzen darum auf Grund der Entwicklung des Mittelwertes ab, ob denn die gewogenen Objekte noch zur selben Grundgesamtheit gehören nötig macht.
Diese Verfahren werden denn auch zum Beispiel beim Litz beschrieben.
Die FPV hat aber noch einen weiteren Aspekt, der eine Schätzung, ob denn Objekte zur selben Grundgesamtheit nötig machen kann.
Die Objekte müssen zum Zeitpunkt die FPV einhalten, an dem sie in den Verkehr gebracht werden.
Das kann aber Monate oder gar Jahre nach der Produktion sein.
Man muss also zumindest abschätzen, ob sich die Produkte bis dahin nicht verändert haben.
Der Mathematik ist es völlig egal, ob die Veränderung des Gewichts durch Lagerung oder Schrumpfungsprozesse bei Sporen durch Lagerung untersucht werden.
Konkretes Beispiel aus der Praxis:
Bei Spraydosen ist mit Leckagen zu rechnen.
Darum machen die Hersteller solcher Dosen folgendes:
Sie ermitteln aus einer großen Anzahl produzierter Dosen die statistischen Kennwerte.
n Größenordnung mehrere Tausend. Wenn man das besonders gut machen will, kann man zum Beispiel auch die Produktion eines ganzen Jahres untersuchen.
Dann ist n > 100000.
Die Produzenten entnehmen aus einer Charge eine Stichprobe von 20 Stück und lagern sie ein halbes Jahr ein.
Danach messen Sie diese Stichprobe erneut und nehmen die statistischen Kennwerte der Probe.
Damit kann man abschätzen, ob denn die Probe zur gleichen Grundgesamtheit gehört.
Die schätzen dann auch die Größe der Leckage auf Grund der Daten, das hat aber mit dem, was Du machen willst, nichts zu tun.
Anderes Beispiel: Spraydosen, die Medikamente enthalten.
Da muss abgeschätzt werden, ob die Dosis, die bei einem Sprühstoß aus der Dose kommt, nach Lagerung noch die gleiche wie vorher ist.
Also ob die Medikamentendosis vor und nach der Lagerung aus der gleichen Grundgesamtheit stammt.

Wenn Du deine Ziele erreichen willst, wirst Du nicht darum herumkommen, große Datenmengen zu verarbeiten.
Ich habe dazu auch konkrete Vorgehensweisen benannt.
Ich könnte noch ergänzen, dass es bei kleinen Stichproben sinnvoll sein kann, den Mittelwert über den Median zu schätzen.
Dazu gibt es auch Theorie, aber dabei gibt es das schon mehrfach benannte Problem.
Um anzugeben was klein ist, braucht man sehr genaue Informationen über die Grundgesamtheit.
Eine solche Untersuchung scheint mir allerdings in der Realisierung eher ein Aufwand von einer oder mehreren Doktorarbeiten zu sein.
Außerdem sollten da mindestens zwei Disziplinen beteiligt sein: Sowohl ein Mathematiker als auch ein Biologe.
Eventuell noch ein Informatiker zur Erarbeitung von Algorithmen zur Mustererkennung, die bei der vorliegender Datenmenge - bei Bildern sehr viel - in einer Zeit < 1Jahr terminieren.
Deshalb die "Abschweifung" aus meiner Berufserfahrung.

Ich finde das ganze Thema übrigens sehr interessant und eben darum solche Bemühungen sehr verdienstvoll.
Die Mykologie verlässt sich bei der Bestimmung von Arten sehr stark auf näherungsweise konstante Abmessungen der Sporen.
Mir ist nicht bekannt, dass jemand diese Vorgehensweise jemals evaluiert hätte.
Ich finde hingegen Hinweise, dass die Abmessungen bei derselben Art nicht konstant sind.
Werner Jurkeit hat zum Beispiel nach seinen Angaben einige Russula Myzel in verschiedenen Jahren besucht.
Dabei fand er merklich verschiedene Sporenmaße in verschiedenen Jahren.
Er findet solche Abweichungen aber auch bei allen anderen Merkmalen, die zur Bestimmung herangezogen werden.
Er fokussiert in seinen Analysen darum auf das Biotop, in dem die Täublinge wachsen, und die pflanzlichen Partner.
Außerdem hat er sehr intensiv andere nur mikroskopisch erkennbare Strukturen untersucht.
Auch Ursula hat hier schon berichtet, dass bei eindeutig bestimmten Trivialarten oft die Sporenmaße davon abweichen, was in der Literatur steht.

Ich habe einen Sportkameraden, der mit gutem Erfolg an der Mathematikolympiade teilgenommen hat.
Er arbeitet mittlerweile beim Fraunhofer Institut und macht dort statistische Auswertungen für die Industrie.
Wenn ich so etwas in Angriff nehmen wollte, würde ich bei Fraunhofer nachfragen, ob man da nicht ein Projekt starten könnte.
Die sind bestimmt bereit, auch Projekte mit Unis zu machen.

Gruß,
Marcel

Re: Normalverteilung @Lupus: nicht für dich ;-)

Krötenhocker, (vor 477 Tagen) @ Marcel Weymann

Hallo Marcel,

...die Verteilung nur näherungsweise eine Normalverteilung ist.

Na und?

Das heißt, wenn Du mit deiner Methode Konfidenzintervalle bestimmst, ist das
keine Messung, weil Du die Genauigkeit noch nicht einmal abschätzen
kannst.

Ich messe die Einzelwerte und berechne die Konfidenzintervalle und Populationsgrenzen. Willst du die Mathematik dazu in Frage stellen? Und noch einmal: Ich gebe die Genauigkeit doch selber vor!

Damit ist deine Messeinrichtung nur ein sogenanntes Schätzeisen.

Jede Messung ist eine Schätzung. Ein wenig optimieren können wir die Schätzungen mit mehreren Messungen.

Mir ist kein Fall bekannt, bei dem jemand mit Hilfe so bestimmter
Konfidenzintervalle Ziele, wie Du sie angibst, erreicht hat.

Welche Ziele meinst du? 2-Stichproben-t-Test? ANOVA? Kannst du bitte mitteilen, was du wie verstanden hast? Also welche Ziele ich verfolge?

Wer darüber nachdenkt, so etwas zu verwenden, sollte es zuerst per Simulation
testen.

Nein! Meine Ziele habe ich klar definiert. Dafür sind bei diesem Stand keine Simulationen nötig. Ich lese mich gerade in die Bayes-Statistik und die Clusteranalyse ein. Die Methoden scheinen auch klar definiert. Falls du Maximum Likelihood oder Bootstap meinst. Auch diese Methoden sind klar definiert.

Nachdem Du in der Vergangenheit für deine Methode damit geworben hast, dass
das in der Technik jeder so mache, findest ich es befremdlich, dass Du
nachdem ich Dir die Probleme deiner Vorgehensweise gezeigt habe,
die Aussage machst, in der Technik gelte eine andere Mathematik als in der
Biologie.

Nein, du liest nicht genau.
1. Die Mathematik ist gleich
2. Die angewandte Mathematik ändert sich hinsichtlich der Anforderungen

Du verweist mehrfach auf die Ziele, die Du verfolgst, die ja andere seien als
die in der Technik.
Die Mathematik interessiert sich nicht für die Ziele, die Du verfolgst.

Natürlich nicht! Das ist ja das nette an der Mathematik ;-)
Und natürlich gibt es auch in der Technik ähnlich geartete Probleme. Aber darum geht es hier nicht!

Zunächst einmal hatte ich allgemein von der Messung des Gewichts gesprochen
und FPV nur als Beispielanwendung angegeben.
Aber auch deine Behauptung, bei der FPV ginge es um die Einhaltung von
Toleranzen, ist falsch.
Bei der FPV gibt es zum Beispiel auch eine Mittelwertforderung.

Aha, gleich falsch, weil wohl doch nicht nicht nur um die Einhaltung von Toleranzen geht? Zum Glück gibt es auch einen Mittelwert... Egal!
Ich bitte dich, wieso versuchst du alles auf deine Verpackungsverordnung herunter zu brechen? Du hast anscheinend auch völlig überlesen, dass ich hier über eine ENDLICHE Grundgesamtheit rechnen möchte.

Wenn Du deine Ziele erreichen willst, wirst Du nicht darum herumkommen, große
Datenmengen zu verarbeiten.

Wenn du jetzt meinst, dass ein paar Stichprobendaten große Datenmengen sind? OK, kann ich!

Ich habe dazu auch konkrete Vorgehensweisen benannt.

Nein, hast du nicht! Wenn doch würde ich mich über eine Präzision deiner Aussage freuen. Große Datenmengen sind es jedenfalls nicht. Die Methoden, die ich hier anwenden möchte, sind längst pupliziert.

Ich könnte noch ergänzen, dass es bei kleinen Stichproben sinnvoll sein kann,
den Mittelwert über den Median zu schätzen.
Dazu gibt es auch Theorie, aber dabei gibt es das schon mehrfach benannte
Problem.

Jupp..., kann aber oft nur zeigen, dass man über andere Verteilungen nachdenken müsste und medianbasierte Berechnungen haben bei Anwendung nicht die gleiche Power.

Um anzugeben was klein ist, braucht man sehr genaue Informationen über die
Grundgesamtheit.

Ja, die haben wir. Und die ist entweder normalverteilt oder eine Mischpopulation oder ich lass mich überrraschen (natürlich hier auf Sporenmessungen bezogen). Nein, die Größe der Stichprobe wird eher durch spätere Methoden beeinflußt. So schreibt (Sachs glaube ich wars), dass man für Bootstrap besser 50+ Messwerte vorhält.

Eine solche Untersuchung scheint mir allerdings in der Realisierung eher ein
Aufwand von einer oder mehreren Doktorarbeiten zu sein.
Außerdem sollten da mindestens zwei Disziplinen beteiligt sein: Sowohl ein
Mathematiker als auch ein Biologe.

Schrieb ich schon: wir sind hier in der Biostatistik!

Ich finde das ganze Thema übrigens sehr interessant und eben darum solche
Bemühungen sehr verdienstvoll.
Die Mykologie verlässt sich bei der Bestimmung von Arten sehr stark
aufnäherungsweise konstante Abmessungen der Sporen.

Na ja, die Abmessungen kommen in Schlüsseln vor, aber in der Regel eher, wenn sich die "Populationsgrenzen" nicht überlappen. Die sind extra in "".

Mir ist nicht bekannt, dass jemand diese Vorgehensweise jemals evaluiert
hätte.

Ich verstehe "Vorgehensweise" nicht.

Ich finde hingegen Hinweise, dass die Abmessungen bei derselben Art nicht
konstant sind.

Sind sie auch nicht. Nur, wie groß sind die Unterschiede wirklich. Es gibt dazu Literatur von Groß ,von Parmasto und ? Hab noch mehr, kann mich aber nicht an alles erinnern.

Werner Jurkeit hat zum Beispiel nach seinen Angaben einige Russula Myzel in
verschiedenen Jahren besucht.
Dabei fand er merklich verschiedene Sporenmaße in verschiedenen Jahren.

Ja, und wie groß waren die Unterschiede? Hast du da eine Quelle? Waren sie meiose- oder mitosebedingt? Fruchtkörpergröße und -alter spielen wahrscheinlich auch eine Rolle. Umwelteinflüsse?
Wie groß allerdings die Unterschiede sind (signifikant)und ob man sie auf alle Arten übertragen kann oder ob sich, wie phylogenetisch gezeigt wird, oft Aggregate hinter Arten verbergen, kann man morphologisch womöglich nachvollziehen oder eben nicht. Das kann man nur über verlässliche Daten bestätigen. Also zum Beispiel bitte nach Objektivtaustausch am Mikroskop auch neu kalibrieren. War schon mal mein Fehler. Und ich hab sehr viele Stichproben weggeworfen, weil ich da nicht dran gedacht hatte, und ich den Tausch nicht mehr temporär festmachen konnte.

Auch Ursula hat hier schon berichtet, dass bei eindeutig bestimmten
Trivialarten oft die Sporenmaße davon abweichen, was in der Literatur steht.

Ja, weil in der Literatur fast nie sinnvoll bearbeitete Stichproben angegeben werden und zudem womöglich nie eigene Daten erhoben wurden.

VG, Jens

Re: Normalverteilung

Marcel Weymann, (vor 473 Tagen) @ Krötenhocker

Hallo Jens,
ich habe folgende Quelle gefunden, die für mich verständlich einige Grundlagen der Zufallsprozesse beschreibt, die Du beobachten willst.
https://statistikgrundlagen.de/ebook/chapter/parameterschaetzung/
https://statistikgrundlagen.de/ebook/chapter/konfidenzintervalle/
Sie enthalten auch einige Abschätzungen, die ich so noch nicht kannte.
Ich möchte grob angeben, wie ich das verstehe.
Du hast einen Zufallsprozess "Sporenwachstum".
Weiterhin gibt es einen Zufallsprozess "Messung Sporengröße"
Du definierst eine Zufallsvariable "gemessene Sporengröße"
Diese Variable ergibt sich aus der Summe:
tatsächliche Sporengröße + Messfehler
Nun nimmst Du aus der Grundgesamtheit dieses Zufallsprozesses eine Stichprobe.
Das ist ein neuer Zufallsprozess.
Jetzt definierst Du folgende Zufallsvariablen dieses zweiten Prozesses:
Mittelwert
Streuung
Konfidenzintervall
Du nimmst an, dass diese Zufallsvariablen erwartungstreue Schätzer derselben Parameter der Grundgesamtheit sind.
Weiterhin nimmst Du an, dass diese Schätzer für das von Dir verwendete n (z.B.100) eine definierte maximale Ungenauigkeit haben.
Dazu gibt es aber keinerlei Hinweise in der Literatur.

Ein Erwartungswert ist ein Limes(n -> Unendlich)
Ich gebe ein Trivialbeispiel, für das man die Genauigkeit für ein bestimmtes n angeben kann.
Limes( n > Unendlich )( ( n + Konstante ) / n )
Wie zumindest ich in der Schule gelernt habe, ist der Grenzwert 1 - den Beweis bekäme ich auch noch hin.
Nehmen wir an die Konstante wäre 1.
Dann ist für n = 1000 der Schätzwert 1.001.
Nehmen wir jetzt aber an Konstante ist 1000, dann ist für n = 1000 der Schätzwert 2.

Jetzt zu deinem Problem. Ich hatte das so verstanden, dass Du prüfen willst, ob Stichproben von derselben Grundgesamtheit genommen wurden.
Ich habe in meiner beruflichen Praxis sehr häufig erlebt, dass Leute nach dem Aufwand einer Softwareerweiterung fragen und dabei das Problem nicht angeben, dass sie damit lösen wollen.
Stattdessen möchte der Kunde seine Lösungsvorstellung programmiert haben.
Das scheitert dann oft an zwei möglichen Ursachen:
1. Das wird so aufwendig, dass das keiner bezahlen will.
2. Die Lösung funktioniert nicht. Ich habe Fälle erlebt, in denen man das den Leuten nicht gesagt hat.
Die schrieben dann hinterher, dass das das letzte gewesen sei, was sie bei der Firma gekauft hätten.
Wir haben in solchen Fällen möglichst genau versucht herauszufinden, was das eigentliche Problem ist.
Wir konnten dann stets eine bezahlbare Lösung anbieten.

Ich vermute, dass Du eigentlich wissen willst, ob zwei Stichproben zur selben Pilzart gehören.
Wenn man das erreichen will, muss man vor allem die statistischen Daten der Grundgesamtheit möglichst gut erfassen.
Am besten mit sehr großen Stichproben.
Die angegebene Literatur gibt aber auch eine andere Methode an, an die ich nicht gedacht hatte.
Man verbessert die Schätzung von Mittelwert und Streuung, indem man aus mehreren kleineren Stichproben bessere Schätzer bildet.
Es sind dort Formeln angegeben.
Die Vorgehensweise ist mir unmittelbar einsichtig und ich empfehle das.

Die Ergebnisse seiner lebenslangen Forschung hat Werner Jurkeit in seinem Buch Die Gattung "Russula Band I-IV - JURKEIT, W." beschrieben.
Er beschreibt sehr ausführlich die Variabilität der gefunden Merkmale.
Die Angabe über die Sporen habe ich diesen Ausführungen entnommen.
Band I und II sind erschienen.
Als Subskribent warte ich sehnsuchtsvoll auf die letzten zwei.

Gruß,
Marcel

Re: Normalverteilung

Krötenhocker, (vor 473 Tagen) @ Marcel Weymann

Hallo Marcel,

Ich vermute, dass Du eigentlich wissen willst, ob zwei Stichproben zur selben
Pilzart gehören.

Man kann das nicht wissen. Man kann das mit einem t-Test oder Welch Test testen. Ich hänge mal so ein Ergebnis an.

Am besten mit sehr großen Stichproben.

Begründe bitte deine sehr großen Stichproben. Welchen Mehrwert haben sie gegenüber einer Stichprobe aus 50 Messungen? Ja, das Konfidenzintervall wird kleiner. Aber dafür handele ich mir immer mehr Ausreißer ein.
Ich habe jetzt mal mit Bootstrap (also nicht die klassische Statistik) mit bis zu 10000 Zufallsstichproben mit Ziehen und Zurücklegen aus der Stichprobe rechnen lassen. Und siehe da, trotzdem es Ausreißer gibt, kommen beide Varianten auf fast gleiche Ergebnisse. Das war jetzt allerdings ein einmaliger Test.
Ich hänge, wenn es geht, eine PDF mit dem Plot an. PDF geht nicht. Ich hänge ein Bild mit den Werten der klassischen Berechnung und ein Bootstrap

Die angegebene Literatur gibt aber auch eine andere Methode an, an die ich
nicht gedacht hatte.
Man verbessert die Schätzung von Mittelwert und Streuung, indem man aus
mehreren kleineren Stichproben bessere Schätzer bildet.

Die dürfte man dann aber auch erst nach bestandenen Vortests einfach zusammen schmeißen.

Es sind dort Formeln angegeben.
Die Vorgehensweise ist mir unmittelbar einsichtig und ich empfehle das.

Was genau du empfielst bleibst du aber schuldig?

Er beschreibt sehr ausführlich die Variabilität der gefunden Merkmale.

Ja, hatte ich ja auch schon erwähnt, siehe z.B.:
Gross, G. (1972) Kernzahl und Sporenvolumen bei einigen Hymenogasterarten - ZfP 38 - p109-157
Gross, G. (1976) Messen von Pilzsporen- ZfP 42- 211 ff
Krüger, H.- Die normierte Sporenmessung - Diskussion von Voraussetzungen und Vorstellung eines Lösungsansatzes - Z. Mykol. 53 (1) -p99-118 (1987)
Parmasto, E.& I., (1987)- Variation of basidiospores in the Hymenomycetes - BIBLIOTHECA MYCOLOGICA Bd 115
oder hier von Heinz Clemencon:
https://www.google.com/url?sa=t&amp;source=web&amp;rct=j&amp;opi=89978449&amp;url=https...

Um mal signifikante Aussagen darüber treffen zu können, benögt man Daten, Daten, Daten. Und ich glaube, dass die Variation der Sporenmaße oft von der Durchmischung (Mehrkernigkeit der Sporen) beeinflußt sind.

VG, Jens

[image]

Sreenshot 2-Stichproben t-Test aus Smaff

Krötenhocker, (vor 473 Tagen) @ Krötenhocker

[image]

Falsche Grafik! Richtige Auswertung kommt jetzt

Krötenhocker, (vor 472 Tagen) @ Krötenhocker

Hallo Marcel und an die interessierten Leser,

leider habe ich zwischen Tür und Angel die falschen Daten mit Plot präsentiert, welche schon keine Ausreißer mehr mit drin hatten. Hier die klassische Statistikauswertung mit den Originaldaten. Eingekringelt sind die Werte, welche ich in der Bootstrap-Grafik zeige. Es gibt trotz des Vorhandenseins von Ausreissern eine erstaunliche Übereinstimmung zwischen klassischer und Bootstrap Methode. Ach ja, nicht über die Nachkommastellen wundern. Es sind zu viele und ich habe sie benötigt, um zu testen, wie genau ich auf alle anderen Werte jeweils zurückrechnen kann. In Smaff sind es später sinnvolle Nachkommastellen, oder einstellbar.

VG, jens

[image]

Re: Falsche Grafik! Richtige Auswertung kommt jetz

Marcel Weymann, (vor 464 Tagen) @ Krötenhocker

Hallo Jens,
ich möchte nun auf die konkrete Auswertung eingehen, die Du mir geschickt hast.
Du schreibst "Ach ja, nicht über die Nachkommastellen wundern. Es sind zu viele .."
So etwas wie zu viele Nachkommastellen bei berechneten Werten gibt es nicht.
Ich vermute Du hast in der Schule wie ich auch gelernt, dass man nicht mehr Nachkommastellen angeben soll, als man bei den Eingangsdaten angibt.
Das stammt aus Zeiten, in denen man alles per Hand rechnen musste. Bei Verwendung von Computern ist das überholt.
Warum man das früher gemacht hat:
Es dauert bis ein Mensch zum Beispiel 10000 Multiplikationen durchgeführt hat. Man hat 2 Möglichkeiten solche Berechnungen effektiv durchzuführen:
1. Mann nimmt große n und rechnet mit wenig Nachkommastellen.
2. Man nimmt kleinere n und rechnet mit mehr Nachkommastellen.
Die Erfahrung hat gezeigt, dass Methode 1 die besseren Resultate bringt.

Für die Darstellung von Messwerten gelten andere Regeln, die auch bei einer Eichung geprüft werden.
Messwerte dürfen nicht genauer angegeben werden als die Genauigkeit, für die das Messinstrument geeicht ist.
Für Auswertungen - wie zum Beispiel Mittelwert oder Streuung - gilt das nicht, da dürfen zusätzliche Nachkommastellen angegeben werden.
Diese Vorgaben kann man nur verstehen, wenn man sich ein wenig mit numerischer Mathematik befasst. Stichwort Fehlerfortplanzung

Ich gebe ein Beispiel, welche Fehler man sich einhandelt, wenn man zu früh rundet:
X1 = 1.231
X2 = 1.232
( X2 - X1 ) * 1000
ergibt 1 wenn ungerundet
0 wenn auf 2 Stellen gerundet.
Das ist jetzt ein Trivialbeispiel.
Es gibt aber leider auch so etwas ähnliches wie eine Rundung, wenn man eine Gleitkommazahl im Computer speichert.
Es wird nie der tatsächliche Wert gespeichert, sondern der Wert aus dem Wertevorrat, der ihm am nächsten ist.
Python hat 64Bit Gleitkommazahlen. Das ist zwar recht genau, aber auch damit kann man in das Problem laufen, dass ein korrekter Algorithmus aus Gründen der numerischen Mathematik völlig falsche Ergebnisse liefert.
Im Studium empfahl man darum, immer eine Probe zu machen und zeigte abschreckende Beispiele, bei denen zum Beispiel ein Gaußscher Algorithmus zur Lösung von n Gleichungen mit n Unbekannten Unsinn berechnete.
Wie oben gezeigt sind insbesondere Differenzen von fast gleichen Werten gefährlich. Man sollte das immer im Auge behalten.
Der Varianzschätzer verwendet zum Beispiel eine Differenz.

Nun zu deinem Bild. Du gibst nicht an, wie groß n war.
Ich kann nur raten, dass es eher klein war, weil Du nur 6 Balken gebildet hast.
Ich habe mich hier ein wenig sachkundig über KDE Kurven gemacht:
https://de.wikipedia.org/wiki/Kerndichteschätzer
Auszug:
"Man sieht deutlich, dass die Qualität des Kerndichteschätzers von der gewählten Bandbreite abhängt.
Eine zu kleine Bandbreite erscheint „verwackelt“, während eine zu große Bandbreite zu „grob“ ist."
Deine Darstellung scheint mir zu grob zu sein.
Wenn Du aber feiner einteilst, hast Du vermutlich eine stark "verwackelte" Grafik, weil das n so klein ist, dass Einzelmessungen einen zu großen Einfluss haben.

Deine Grafik zeigt übrigens deutliche Ähnlichkeiten der statistischen Merkmale mit anderen Grafiken, die ich gesehen habe, die Sporenmessungen wiedergeben.
Die Verteilung ist deutlich schief, deshalb befinden sich auch Messwerte außerhalb der von Dir berechneten "Konfidenzintervalls".
Sie sind allerdings deutlich erkennbar nicht weit (in Bezug auf die geschätzte Streuung) von diesem Intervall entfernt.
Wie man dann auf den Gedanken kommt, diese Messwerte als Ausreißer auszuschließen, kann ich nicht nachvollziehen.
Ich würde daraus schließen, dass dein Schätzer für das Konfidenzintervall unzureichende Ergebnisse bringt und diese darum nicht angeben.
Vielleicht gibt es irgendwo jemanden, der für beliebige Verteilungen einen besseren Schätzer entworfen hat. Ich kenne so etwas nicht.
Zum Thema Ausreißertests möchte ich zunächst auf folgende Seite verweisen:
https://de.wikipedia.org/wiki/Ausreißer
Weiterhin wird hier ein Test angegeben, der ohne die Annahme Normalverteilung auskommt:
https://de.wikipedia.org/wiki/Ausreißertest_nach_Walsh
Hier ist explizit n=60 als nötig genannt.

Noch ein Nachtrag zum Buch von Werner Jurkeit.
Er zeigt unter anderem Mikrofotos verschiedener Arten, auf denen schon eine merkliche Anzahl von Sporen pro Art abgebildet sind.
Vielleicht vermesse ich die mal irgendwann und mache statistische Auswertungen.
Fotos haben den großen Vorteil, dass sie still halten und dass man sie kopieren kann.
Man kann dann vermeiden, dass eine Spore 2 Mal gemessen wird, indem man sie auf Papier markiert.
Wenn man keine Zeit mehr zum Weitermachen hat, kann man das am nächsten Tag machen.
Ich schau mich perspektivisch auch mal nach Programmen zur Mustererkennung um.

Gruß,
Marcel

Re: Falsche Grafik! Richtige Auswertung kommt jetz

Krötenhocker, (vor 464 Tagen) @ Marcel Weymann

Hallo Marcel,

ich möchte nun auf die konkrete Auswertung eingehen, die Du mir geschickt
hast.
Du schreibst "Ach ja, nicht über die Nachkommastellen wundern. Es sind
zu viele .."
So etwas wie zu viele Nachkommastellen bei berechneten Werten gibt es nicht.
Ich vermute Du hast in der Schule wie ich auch gelernt, dass man nicht mehr
Nachkommastellen angeben soll, als man bei den Eingangsdaten angibt.
Das stammt aus Zeiten, in denen man alles per Hand rechnen musste. Bei
Verwendung von Computern ist das überholt.
Warum man das früher gemacht hat: Es dauert bis ein Mensch zum Beispiel 10000
Multiplikationen durchgeführt hat. Man hat 2 Möglichkeiten solche
Berechnungen effektiv durchzuführen: 1. Mann nimmt große n und rechnet mit
wenig Nachkommastellen.
2. Man nimmt kleinere n und rechnet mit mehr Nachkommastellen.
Die Erfahrung hat gezeigt, dass Methode 1 die besseren Resultate bringt.

Danke für die Aufklärung. Das mit den Nachkommastellen habe ich anders gelernt, aber es geht auch um den Kompromiss zwischen Leserlichkeit und Genauigkeit.
Es ist allerdings egal, wieviele ich angebe, wenn ich die Originaldaten vorhalte und die Nachkommastellen im Prog beliebig einstellbar mache.

Für die Darstellung von Messwerten gelten andere Regeln, die auch bei einer
Eichung geprüft werden.
Messwerte dürfen nicht genauer angegeben werden als die Genauigkeit, für die
das Messinstrument geeicht ist.
Für Auswertungen - wie zum Beispiel Mittelwert oder Streuung - gilt das
nicht, da dürfen zusätzliche Nachkommastellen angegeben werden.
Diese Vorgaben kann man nur verstehen, wenn man sich ein wenig mit
numerischer Mathematik befasst. Stichwort Fehlerfortplanzung

Jupp.

Ich gebe ein Beispiel, welche Fehler man sich einhandelt, wenn man zu früh
rundet: X1 = 1.231
X2 = 1.232
( X2 - X1 ) * 1000
ergibt 1 wenn ungerundet
0 wenn auf 2 Stellen gerundet.
Das ist jetzt ein Trivialbeispiel.

Ja, und es ist bei Sporenmessungungen auch egal. Wir sind hier in der Biologie. Keiner will supergenaue Zahlen lesen, weil die Unterschiede zwischen Sporemessreihen und deren Streuung um den Mittelwert größer sein kann, als man mit Nachkommastellen über 2 anzeigen sollte. Das bedeutet ja nicht, dass man nicht größerer Genauigkeit rechnet. Die Publikation und die Berechnung bleiben zwei paar Schuhe.

Es gibt aber leider auch so etwas ähnliches wie eine Rundung, wenn man eine
Gleitkommazahl im Computer speichert.
Es wird nie der tatsächliche Wert gespeichert, sondern der Wert aus dem
Wertevorrat, der ihm am nächsten ist.
Python hat 64Bit Gleitkommazahlen. Das ist zwar recht genau, aber auch damit
kann man in das Problem laufen, dass ein korrekter Algorithmus aus Gründen
der numerischen Mathematik völlig falsche Ergebnisse liefert.

Aber nicht hier! Da müsstest du dich mit Martin im Nachbarthread und der Unschärfetheorie auseinandersetzen Da bist in den Nachkommastellen.

Im Studium empfahl man darum, immer eine Probe zu machen und zeigte
abschreckende Beispiele, bei denen zum Beispiel ein Gaußscher Algorithmus
zur Lösung von n Gleichungen mit n Unbekannten Unsinn berechnete.

Genau, immer eine PROBE machen. Ich nenne das hier StichPROBE. Darauf basieren erste Scchätzungen zur Grundgesamtheit. Mit vielen Sichproben kommt man vielleicht zu neuen Erkenntnissen.

Wie oben gezeigt sind insbesondere Differenzen von fast gleichen Werten
gefährlich. Man sollte das immer im Auge behalten.
Der Varianzschätzer verwendet zum Beispiel eine Differenz.

Die Unterschiede spielen hier keine Rolle. Es werden Hypothesentests (auch mit der Varianz) auch bei nicht vorhandender Normalverteilung durchgeführt. Dazu wird immer wieder geschrieben, dass die Hyphothesentests relativ robust auf nur annähernde Normalverteilung reagieren.

Nun zu deinem Bild. Du gibst nicht an, wie groß n war.

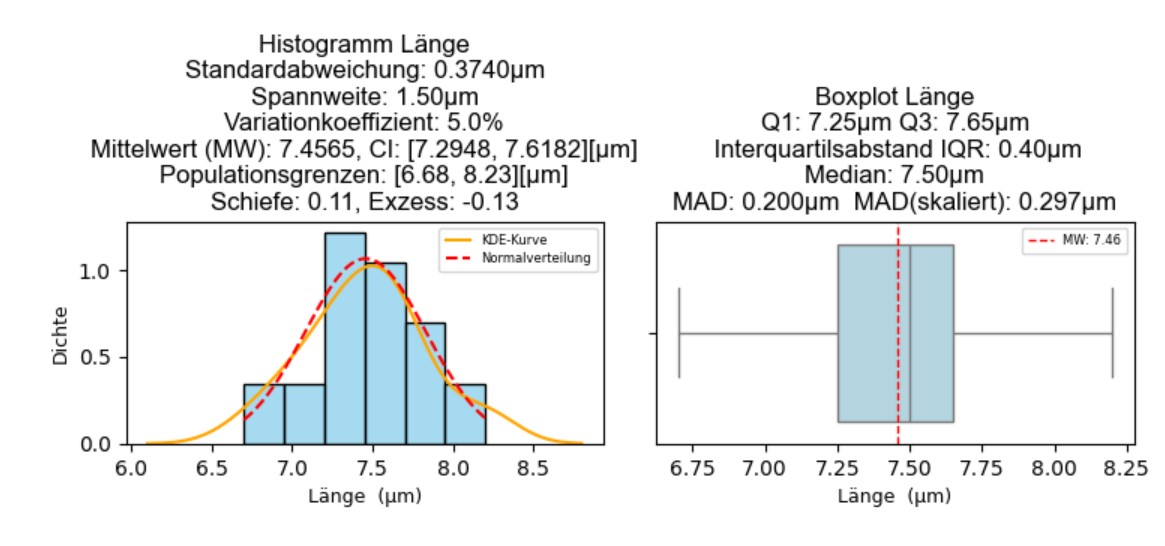
Das stimmt, sollte aber auch nur ein Beispiel sein, was für Werte ich mit berechne. Weil du z.B. auf den Median hingewiesen hast.

Ich kann nur raten, dass es eher klein war, weil Du nur 6 Balken gebildet
hast.

Die Formel für die Balken (ich glaube du mußt nach bins suchen) findest du bei Wikipedia.

Ich habe mich hier ein wenig sachkundig über KDE Kurven gemacht:
https://de.wikipedia.org/wiki/Kerndichtesch ätzer
Auszug: "Man sieht deutlich, dass die Qualität des Kerndichteschätzers
von der gewählten Bandbreite abhängt.
Eine zu kleine Bandbreite erscheint „verwackelt“, während eine zu große
Bandbreite zu „grob“ ist."
Deine Darstellung scheint mir zu grob zu sein.

Nein, es geht um Vergleichbarkeit. Hier z.B. auch, wie kumulierte Kerndichte mit der kumulierten Normalverteilung korrespondiert. Also für mich. Wenn du gerne etwas anderes sehen möchtest, mach Vorschläge.

Wenn Du aber feiner einteilst, hast Du vermutlich eine stark
"verwackelte" Grafik, weil das n so klein ist, dass
Einzelmessungen einen zu großen Einfluss haben.

Ja, die Anzahl der Balken ist immer ein Kompromiss. Ich bleibe heutzutage lieber bei wenigeren, da ansonsten sofort nur diese Grafik Ausreißer oder Schiefe vermutet wird, wo sie nicht relevant sind/ist.

Deine Grafik zeigt übrigens deutliche Ähnlichkeiten der statistischen
Merkmale mit anderen Grafiken, die ich gesehen habe, die Sporenmessungen
wiedergeben.

So viele Möglichkeiten gibt es da ja nicht. Und es geht auch immer um Vergleichbarkeit.
Und bitte zeige oder nenne mir Beispiele! Ich bin immer auf der Suche nach Optimierungen oder anderen Sichtweisen. Es kann auch immer sein, dass ich mich in etwas verrannt habe oder etwas anders gemacht wird. Man kann nicht alles zum Thema kennen.

Die Verteilung ist deutlich schief, deshalb befinden sich auch Messwerte
außerhalb der von Dir berechneten "Konfidenzintervalls".

Hier bei der Länge ist im Boxplot einer zu sehen (nicht nach der Theorie der Normalverteilung). Aber der Plot zeigt ja nicht die Populationsgrenzen.

Sie sind allerdings deutlich erkennbar nicht weit (in Bezug auf die
geschätzte Streuung) von diesem Intervall entfernt.
Wie man dann auf den Gedanken kommt, diese Messwerte als Ausreißer
auszuschließen, kann ich nicht nachvollziehen.

Über Ausreißertests! Sind nur Theorien, aber nicht widerlegte...

Du siehst nur einen kleinen Ausschnitt und du darfst die Verteilung nicht nur anhand des Boxplots bewerten. Schiefe ergibt sich aus den Daten und ist mit angegeben. Zudem siehst du in den Boxplots die Nähe von Median und Mittelwert.

Ich würde daraus schließen, dass dein Schätzer für das Konfidenzintervall
unzureichende Ergebnisse bringt und diese darum nicht angeben.

"unzureichende Ergebnisse" bringt er für was? Da fehlt mir der Bezug.
Aber was auch immer du da sagen willst, würde mich interessieren, was du stattdessen angeben würdest?

Vielleicht gibt es irgendwo jemanden, der für beliebige Verteilungen einen
besseren Schätzer entworfen hat. Ich kenne so etwas nicht.
Zum Thema Ausreißertests möchte ich zunächst auf folgende Seite verweisen:
https://de.wikipedia.org/wiki/Ausrei ßer
Weiterhin wird hier ein Test angegeben, der ohne die Annahme Normalverteilung
auskommt: https://de.wikipedia.org/wiki/Ausrei ßertest_nach_Walsh
Hier ist explizit n=60 als nötig genannt.

Ich rechne die Ausreisser unter Normalverteilungsannahme. Ich versuche damit soviel Power wie möglich in erste Ergebnisse zu bringen.

Noch ein Nachtrag zum Buch von Werner Jurkeit.
Er zeigt unter anderem Mikrofotos verschiedener Arten, auf denen schon eine
merkliche Anzahl von Sporen pro Art abgebildet sind.
Vielleicht vermesse ich die mal irgendwann und mache statistische
Auswertungen.

Ja, und nach vielen Jahren eigener Erfahrungsammlung liest du dir dann unseren Thread noch einmal durch und du wirst dich fragen, wieso du so viel in Frage gestellt hast?

Fotos haben den großen Vorteil, dass sie still halten und dass man sie
kopieren kann.
Man kann dann vermeiden, dass eine Spore 2 Mal gemessen wird, indem man sie
auf Papier markiert.

Genau das hatte ich schon geschrieben. Ich hoffe in diesem Thread. Allerdings sind wir aus dem Papierzeitalter bei so etwas heraus. Wir benutzen heutzutage digitale Daten. Die kann man am Bildschirm vermessen. Das spart zwar einerseits Papier, aber verbraucht Energie. Der Vorteil ist, dass wir die Daten danach weniger Ressourcenverbrauchend diskutieren oder austauschen können.
Mit der zeitnahen Bilderstellung der Präparate kann man ein mögliches anderes Problem dumgehen: Sporen könnten quellen, wenn sie nicht zeitnahg vermessen werden. Exsikkate auch.

Wenn man keine Zeit mehr zum Weitermachen hat, kann man das am nächsten Tag
machen.
Ich schau mich perspektivisch auch mal nach Programmen zur Mustererkennung
um.

Da hätte ich sogar Tipps, also Sporen betreffend. Leider machen es sich die Autoren mit irgendeinem Myxomyceten dadurch einfach, dass dieser runde Sporen hat.

Marcel,es wäre diskussionsvorantreibender, wenn man nicht immer neue Schubladen aufmacht, sondern auch mal welche zumachen könnte. Du gehst auf nichts weiter ein, was ich gerne klargestellt hätte. Softwareentwickler seit 36 Jahren ohne Programmierkenntnisse z.B.? Oder wann erkennst du an, das es einen Unterschied zwichen endlicher und unendlicher Grundgesamtheit gibt? Ich habe ein wenig das Gefühl, ich werde zum Narren gehalten. Das kännte Shakespeare sein, oder? Jetzt ich:
Meine Zeit für dich ist nur dann sinnvoll, wenn du sie so wertig nimmst, wie du deine Zeit für mich mit Sinnvollem füllst.

VG, Jens

Re: Falsche Grafik! Richtige Auswertung kommt jetz

Marcel Weymann, (vor 462 Tagen) @ Krötenhocker

Hallo Jens,
Wir scheinen zumindest ein sprachliches Verständigungsproblem zu haben.
Wenn ich schreibe, dass ich kein Programmierer bin, heißt das nicht, dass ich nicht gelegentlich Programmtext eingebe.
Es heißt, dass das nicht meine eigentliche Aufgabe im Berufsleben ist.
Das Eingeben von Quelltexten ist ein Hilfsmittel, genau wie die Mathematik.
Das hat ungefähr den Stellenwert des Multimeters beim Elektriker.
Meine Aufgabe war es stets Probleme zu lösen, deren Lösung man üblicherweise nur einem Ingenieur zutraut.
Die Lösung kann ein Stück neuer Quelltext, eine geänderte Zeile, aber auch eine neue Hardware sein.
Dann stehe ich zum Beispiel mit einem Elektriker auf einer Baustelle und gebe dem Stammsitz der Firma meine Vorstellungen durch, wie der Schaltplan geändert werden sollte und der Elektriker muss das Resultat dann umsetzen.
Manchmal ist die Lösung auch Fehler des Kunden zu finden und ihm zu helfen, die zu vermeiden.
Ein anderes Mal ist die Lösung den Kunden auf eine Konfigurationsmöglichkeit hinzuweisen und ihm zu erklären, wie die funktioniert.

Ich musste mich in vielen Fällen mit Problemen auseinandersetzen, an denen sich andere über längere Zeit die Zähne ausgebissen haben.
Den Rekord stellten Kollegen auf, die über 5 Jahre nicht in der Lage waren, den Fehler in ihrem selbstgestrickten Multitaskingbetriebssystem zu beseitigen.
Ich brauchte 3 Monate und am Ende waren sich alle einig, dass es erstaunlich war, dass das vorher keiner gefunden hatte.

Ich bin durchaus der Meinung, dass Du ein kompliziertes Problem angehen willst.
Meine Lebenserfahrung zeigt, dass man dazu vor allem viele kreative Ideen braucht.
Im genannten Fall habe ich gefühlt endlos viele Dinge ausprobiert. Man fragt sich dann irgendwann ziemlich verzweifelt: Was könnte ich denn jetzt noch versuchen?
Weil mich das Thema Kreativität interessiert, habe ich jüngst folgendes Buch erworben, in der Absicht meine Kreativität zu steigern:
"Bas Kast und plötzlich macht es klick, das Handwerk der Kreativität..."
Ich fand dort allerlei Dinge, die ich schon länger selbst so mache so zum Beispiel:
Nicht zu stark auf das konkrete Problem fixieren.
Aber ein Augenöffner war für mich folgendes:
Er hat die Kreativität von Menschen über (Intelligenz)tests geprüft.
Dabei stellte sich heraus, dass eine Gruppe, der man vorher die Erzählung "Ein Landarzt" von Franz Kafka vorgelesen hat, signifikant kreativer war, als eine bei der man das nicht getan hatte.
Ich kann das nachvollziehen:Kafka war mein Lieblingsautor als Jugendlicher und er hat mir beim Verständnis vieler naturwissenschaftlicher Probleme geholfen.
Was aber ist der Grund für den festgestellte Effekt?
Die Geschichte beginnt als Alltagsbericht aus dem Leben eines Landarztes.
Dann weicht langsam aber sicher jede normale Alltagslogik aus der Geschichte.
Stattdessen tritt eine neue Logik auf, die in sich stimmig ist, aber mit unserem Alltagsdenken nicht mehr vereinbar.
Man lernt daraus, dass es hilft, scheinbar unverrückbare Wahrheiten zu hinterfragen.
Beispiel: Ein Mitschüler sagt, es könne ja nicht sein, dass ein Elektron manchmal eine Welle sei und manchmal ein Teilchen. Das ist in der Tat unserer Alltagslogik nicht zugänglich.
Du hast erkennbar das Prinzip der großen Zahl nicht verinnerlicht. Auch so ein Gesetz, dass unserer Alltagserfahrung widerspricht.
Ich finde auf die Schnelle:
https://de.wikipedia.org/wiki/Gesetz_der_großen_Zahlen
Von Kafka habe ich gelernt auch andere Logiken zu akzeptieren.
Ähnliches kann man bei Shakespeare lernen, wenn man ihn im Original liest.
Da gibt es bei allem oft bitteren Ernst der Dinge immer jemanden der auf witzige Art und Weise die Logik des Handelns der anderen in Frage stellt.
Beispiel Eröffnungsszene Romeo und Julia:
Die zwei Clans beginnen zu kämpfen. Einer der Clanchefs ruft aus: Mein Schwert, mein Schwert man bringe mir mein Schwert.
Seine Frau ruft aus dem Hintergrund: Eine Krücke, eine Krücke, was willst du denn mit einem Schwert?
In Much Ado about nothing gibt es eine Nachtwache, deren Mitglieder sich ständig im Vokabular irren (z.B. sagt einer excommunication, wo er examination meint).
Die Mitglieder werden auf eine Art und Weise eingewiesen, die für eine Nachtwache eher nicht zielführend erscheinent.
Ich finde das zum Brüllen komisch und bekomme davon neue Ideen, wo ich denn zum Beispiel Information zu einem völlig anderen Thema her bekomme.
Der Horizont verengt sich im Leben auf die Dauer immer mehr. Man sollte da immer mal wieder gegensteuern.

Ich schrieb:
Ich gebe ein Beispiel, welche Fehler man sich einhandelt, wenn man zu früh rundet: X1 = 1. X2 = 1.232
( X2 - X1 ) * 1000
ergibt 1 wenn ungerundet
0 wenn auf 2 Stellen gerundet.
Das ist jetzt ein Trivialbeispiel.
Du schreibst:
"Ja, und es ist bei Sporenmessungungen auch egal. Wir sind hier in der Biologie."
Wenn Du Berechnungen mit Messwerten anstellst, ist es egal, was Du da gemessen hast, oder für welchen Wissenschaftszweig Du die Rechnungen anstellst, Du musst die numerische Stabilität prüfen.
Du schreibst:
"Keiner will supergenaue Zahlen lesen, weil die Unterschiede zwischen Sporenmessreihen und deren Streuung um den Mittelwert größer sein kann, als man mit Nachkommastellen über 2 anzeigen sollte.
Das bedeutet ja nicht, dass man nicht größerer Genauigkeit rechnet. Die Publikation und die Berechnung bleiben zwei paar Schuhe."
Ich habe Dir mit einem Beispiel das Problem der numerischen Stabilität erläutert, was hat dein Text damit zu tun?
Ich schrieb:
Es gibt aber leider auch so etwas ähnliches wie eine Rundung, wenn man eine Gleitkommazahl im Computer speichert. Es wird nie der tatsächliche Wert gespeichert, sondern der Wert aus dem Wertevorrat, der ihm am nächsten ist.
Python hat 64Bit Gleitkommazahlen. Das ist zwar recht genau, aber auch damit kann man in das Problem laufen, dass ein korrekter Algorithmus aus Gründen der numerischen Mathematik völlig falsche Ergebnisse liefert.
Du schreibst:
"Aber nicht hier! Da müsstest du dich mit Martin im Nachbarthread und der Unschärfetheorie auseinandersetzen Da bist in den Nachkommastellen"
Du solltest anstatt solche sachfremde Bemerkungen zu machen, versuchen das Problem der numerischen Stabilität zu verstehen.
Man findet zahlreiche Quellen, ob im Internet oder in der Literatur, mit denen man sich einarbeiten kann. Zum Beispiel:
https://www.mat.tuhh.de/lehre/material/NMeth_2010.pdf
Du schreibst:
"Genau, immer eine PROBE machen. Ich nenne das hier StichPROBE."
Bitte begründe, was ein Stichprobe mit eine Probe zu tun hat, die die numerische Stabilität prüft.
Ich schrieb:
"Wie oben gezeigt sind insbesondere Differenzen von fast gleichen Werten gefährlich. Man sollte das immer im Auge behalten.
Der Varianzschätzer verwendet zum Beispiel eine Differenz."
Du schreibst:
"Die Unterschiede spielen hier keine Rolle. Es werden Hypothesentests (auch mit der Varianz) auch bei nicht vorhandender Normalverteilung durchgeführt. Dazu wird immer wieder geschrieben, dass die Hyphothesentests relativ robust auf nur annähernde Normalverteilung reagieren."
Ich beschreibe das Problem der numerischen Stabilität für deine Anwendung. Du verstehst das überhaupt nicht. Hypothesentests sind Rechnungen und da hast Du die numerische Stabilität zu beachten.
Ich schrieb:
"Deine Grafik zeigt übrigens deutliche Ähnlichkeiten der statistischen Merkmale mit anderen Grafiken, die ich gesehen habe, die Sporenmessungen wiedergeben."
Du schreibst:
"So viele Möglichkeiten gibt es da ja nicht".
Es gibt unendlich viele Möglichkeiten, wie die Grundgesamtheit verteilt sein kann.
Als ersten Versuch würde ich prüfen, ob man die gefundene Verteilung nicht transformieren kann, um sie ähnlicher zur Normalverteilung zu machen.
Hier finde ich auf die Schnelle etwas:
https://statistikguru.de/spss/vorraussetzungen-ueberpruefen/daten-transformieren/bekann...
Der zweite Versuch wäre es die höheren Momente zu schätzen und in der Theorie bekannte Verteilungen zu finden, die dieselben haben.
Ich fand ein leider nur antiquarisch erhältliches Buch, das vermutlich - gesehen habe ich den Inhalt nicht - in der Praxis gefundene Verteilungen abbildet.
Du schreibst:
"Und es geht auch immer um Vergleichbarkeit."
Die hat man, wenn man die Verteilung genügend genau beschrieben hat.
Wenn man zum Beispiel feststellt, dass man für alle Stichproben die Ähnlichkeit zur Normalverteilung durch die gleiche Transformation verbessern kann, ist man weiter.

Du schreibst:
"Über Ausreißertests! Sind nur Theorien, aber nicht widerlegte..."
Die von Dir verwendeten Tests setzen Normalverteilung voraus. Ich habe einen parameterfreien Schätzer benannt, der braucht aber n > 60. Das sollte einem zu Denken geben.
Ich zitiere zum Thema Ausreißer folgende Seite:
https://de.wikipedia.org/wiki/Ausreißer
"Liegt ein Ausreißer vor, muss überprüft werden ob es sich bei dem Ausreißer tatsächlich um ein verlässliches und echtes Ergebnis handelt oder ob ein Messfehler vorliegt."
So habe ich das gelernt. Der Dozent erzählte einen Schwank aus seinem Institut. Es sollte eine Anlage eines Industriepartners überwacht werden.
Es fielen immer wieder "Ausreißer" zu ähnlichen Uhrzeiten auf.
Der Dozent legte sich zu diesen Zeiten auf die Lauer und stellte fest, dass eine Putzfrau herein kam, seine Apparatur ausstöpselte und ihren Staubsauger einstöpselte.
Auf die Sporen übertragen: Man müsste jede Messung nachvollziehbar machen, um dieselbe Spore erneut messen zu können.
Dann könnte man prüfen, ob sich Anhaltspunkte ergeben, dass ein Messfehler vorliegt. Das könnte zum Beispiel durch eine Fremdspore passieren, die man zum Beispiel durch Betrachten des Ornaments identifizieren könnte.
Dazu kann ich aber keinerlei Erfahrungen beisteuern.
Du schreibst:
""unzureichende Ergebnisse" bringt er für was? Da fehlt mir der Bezug."
Ich empfinde die Ergebnisse als unzureichend, wenn in der Stichprobe, die Du auswertest, Werte enthalten sind, die nicht in dem von Dir berechneten Konfidenzintervall liegen. Bei solchen winzigen Stichprobe, sollte das nicht passieren.
Du schreibst:
"Aber was auch immer du da sagen willst, würde mich interessieren, was du stattdessen angeben würdest?"
Ich würde Min Max Intervalle deiner Stichprobe angeben. Die kann man dann auch leichter mit anderen Stichproben zusammenfassen.
Du schreibst:
"Ich rechne die Ausreisser unter Normalverteilungsannahme. Ich versuche damit soviel Power wie möglich in erste Ergebnisse zu bringen."
Wenn Du Ausreißer herausnimmst, von denen Du nicht sicher weißt, dass sie welche sind, reduziert Du die Aussagekraft deiner Angaben.

Du schreibst:
"Ja, und nach vielen Jahren eigener Erfahrungsammlung"
Für das Messen von je ca. 60 Sporen für 10 Arten brauche ich nicht so lange. Wenn ich mir ein Programm schreibe, das das macht, kann ich später beliebige Sporenbilder auswerten.
"liest du dir dann unseren Thread noch einmal durch und du wirst dich fragen, wieso du so viel in Frage gestellt hast?"
Die Wahrscheinlichkeit dafür ist gleich 0. Dafür machst Du einfach zu viele methodische Fehler. So hast Du erklärt, dass Du das Zusammenfassen von Stichproben aus verschiedenen Quellen für nicht sinnvoll hältst.
Ich schrieb:
Fotos haben den großen Vorteil, dass sie still halten und dass man sie kopieren kann.
Man kann dann vermeiden, dass eine Spore 2 Mal gemessen wird, indem man sie auf Papier markiert.
Du schreibst:
"Genau das hatte ich schon geschrieben. Ich hoffe in diesem Thread. Allerdings sind wir aus dem Papierzeitalter bei so etwas heraus. Wir benutzen heutzutage digitale Daten. Die kann man am Bildschirm vermessen. Das spart zwar einerseits Papier, aber verbraucht Energie. Der Vorteil ist, dass wir die Daten danach weniger Ressourcenverbrauchend diskutieren oder austauschen können.
Mit der zeitnahen Bilderstellung der Präparate kann man ein mögliches anderes Problem umgehen: Sporen könnten quellen, wenn sie nicht zeitnahe vermessen werden. Exsikkate auch."
Ohne Papier braucht man ein Grafikprogramm, mit dem man vermessen und bemaßen kann. Sind schweineteuer und unangenehm zu bedienen: Auf Papier geht es schneller eine Spore mit einem guten Längenmesser zu messen.
Du schreibst:
"Oder wann erkennst du an, das es einen Unterschied zwischen endlicher und unendlicher Grundgesamtheit gibt?"
Du hattest erklärt, dass Du mit Theorie für eine endliche Grundgesamtheit arbeitest.
Ich hatte Dich darauf hingewiesen, dass Du eine unendliche Grundgesamtheit hast, weil Du Gleitkommazahlen verwendest.
Darauf hast Du nicht geantwortet und sagst jetzt ich solle doch zugeben, dass da ein Unterschied sei.
Du schließt also das erste Thema nicht ab, dass Du aufgemacht hast und fängst stattdessen ein neues an.

Gruß,
Marcel

Re: Falsche Grafik! Richtige Auswertung kommt jetz

Krötenhocker, (vor 462 Tagen) @ Marcel Weymann

Hallo Marcel,

Du hast erkennbar das Prinzip der großen Zahl nicht verinnerlicht. Auch so
ein Gesetz, dass unserer Alltagserfahrung widerspricht.
Ich finde auf die Schnelle: https://de.wikipedia.org/wiki/Gesetz_der_gro
ßen_Zahlen

Wobei soll mir dass denn hier helfen?

Der Horizont verengt sich im Leben auf die Dauer immer mehr. Man sollte da
immer mal wieder gegensteuern.

Ja

Ich schrieb: Ich gebe ein Beispiel, welche Fehler man sich einhandelt, wenn
man zu früh rundet: X1 = 1. X2 = 1.232
( X2 - X1 ) * 1000
ergibt 1 wenn ungerundet
0 wenn auf 2 Stellen gerundet.
Das ist jetzt ein Trivialbeispiel.
Du schreibst: "Ja, und es ist bei Sporenmessungungen auch egal. Wir sind
hier in der Biologie."
Wenn Du Berechnungen mit Messwerten anstellst, ist es egal, was Du da
gemessen hast, oder für welchen Wissenschaftszweig Du die Rechnungen
anstellst, Du musst die numerische Stabilität prüfen.

Ich kann noch ein paar Sporen mehr vermessen und dann schauen, wie sich der Mittelwert verändert oder was meinst du genau?
Ich hab doch die Grafik mit der Bootstrap-Methode gezeigt. Die tut so, als sei die Stichprobe die Grundgesamtheit und resampelt beliebig viele Stichproben aus der Stichprobe. Also mit zurücklegen.
Auf der rechten Seite der Grafik habe ich extra die Werte für Mittelwert und Populationsgrenzen, die dabei berechnet werden, mit angegeben.
Ich war sehr überrascht, dass die Ergebnisse derart ähnlich mit denen der Berechnung auf Normalverteilungsannahme waren.
Hier habe ich methodisch eine Alternative.

Und natürlich wird bei mir erst am Schluß gerundet, falls du da etwas falsch verstanden haben solltest.

Du schreibst: "Keiner will supergenaue Zahlen lesen, weil die
Unterschiede zwischen Sporenmessreihen und deren Streuung um den
Mittelwert größer sein kann, als man mit Nachkommastellen über 2 anzeigen
sollte.
Das bedeutet ja nicht, dass man nicht größerer Genauigkeit rechnet. Die
Publikation und die Berechnung bleiben zwei paar Schuhe."
Ich habe Dir mit einem Beispiel das Problem der numerischen Stabilität
erläutert, was hat dein Text damit zu tun?

Das bedeutet, dass die numerische Stbilität bei z.B. der Berechnungen aus 30 Sporen völlig egal ist. Wo tritt denn der Rundungsfehler bei 64bit Zahlen auf? An der ca. sechzehnten oder siebzehnten Stelle nach dem Komma. Da müsste ich viel mehr Berechnungen durchführen, damit das hier jemals zum Problem wird.
Theoretisch könnte ich ja 32bit Gleitkommazahlenberechnungen machen und mir den Unterschied anschauen. Mach ich aber nicht, weil dafür jede logische Grundlage bei so wenig Berechnungen fehlt.

Ich schrieb: Es gibt aber leider auch so etwas ähnliches wie eine Rundung,
wenn man eine Gleitkommazahl im Computer speichert. Es wird nie der
tatsächliche Wert gespeichert, sondern der Wert aus dem Wertevorrat, der
ihm am nächsten ist.
Python hat 64Bit Gleitkommazahlen. Das ist zwar recht genau, aber auch damit
kann man in das Problem laufen, dass ein korrekter Algorithmus aus Gründen
der numerischen Mathematik völlig falsche Ergebnisse liefert.
Du schreibst: "Aber nicht hier! Da müsstest du dich mit Martin im
Nachbarthread und der Unschärfetheorie auseinandersetzen Da bist in den
Nachkommastellen"
Du solltest anstatt solche sachfremde Bemerkungen zu machen, versuchen das
Problem der numerischen Stabilität zu verstehen.

Das Problem spielt hier keine Rolle.

Man findet zahlreiche Quellen, ob im Internet oder in der Literatur, mit
denen man sich einarbeiten kann. Zum Beispiel:
https://www.mat.tuhh.de/lehre/material/NMeth_2010.pdf
Du schreibst: "Genau, immer eine PROBE machen. Ich nenne das hier
StichPROBE."
Bitte begründe, was ein Stichprobe mit eine Probe zu tun hat, die die
numerische Stabilität prüft.

Nix. Aber ich mach die von dir angedachte Probe nicht. Wenn ich gegen unendlich viele Berechnungen dürchführen müßte, dann wäre es sinnvoll. Aber das passiert hier nicht und meine Variablen werden immer wieder neu initialisiert. Da kann nirgendwo ein Fehler durch zu viele Berechnungen auflaufen.

Ich schrieb: "Wie oben gezeigt sind insbesondere Differenzen von fast
gleichen Werten gefährlich. Man sollte das immer im Auge behalten.

Ja

Der Varianzschätzer verwendet zum Beispiel eine Differenz."
Du schreibst: "Die Unterschiede spielen hier keine Rolle. Es werden
Hypothesentests (auch mit der Varianz) auch bei nicht vorhandender
Normalverteilung durchgeführt. Dazu wird immer wieder geschrieben, dass
die Hyphothesentests relativ robust auf nur annähernde Normalverteilung
reagieren."
Ich beschreibe das Problem der numerischen Stabilität für deine Anwendung. Du
verstehst das überhaupt nicht. Hypothesentests sind Rechnungen und da hast
Du die numerische Stabilität zu beachten.

Siehe die Begründung oben.

Ich schrieb: "Deine Grafik zeigt übrigens deutliche Ähnlichkeiten der
statistischen Merkmale mit anderen Grafiken, die ich gesehen habe, die
Sporenmessungen wiedergeben."
Du schreibst: "So viele Möglichkeiten gibt es da ja nicht".
Es gibt unendlich viele Möglichkeiten, wie die Grundgesamtheit verteilt sein
kann.

Ich bezog mich auf die grafischen Möglichkeiten der Darstellung, nicht der darin enthalten Daten.

Als ersten Versuch würde ich prüfen, ob man die gefundene Verteilung nicht
transformieren kann, um sie ähnlicher zur Normalverteilung zu machen.
Hier finde ich auf die Schnelle etwas:
https://statistikguru.de/spss/vorraussetzungen-ueberpruefen/daten-transformieren/bekann...

Wenn die Normalverteilungstests die Normalverteilung nicht ausschließen, wieso sollte ich dann noch transformieren? Im Programm zeigen Q-Q-Plots die Nähe oder eben nicht zur Normalverteilung auch noch einmal visuell. Hänge ich mal an.

Der zweite Versuch wäre es die höheren Momente zu schätzen und in der Theorie
bekannte Verteilungen zu finden, die dieselben haben.

Ja, die Normalverteilungsmomente beschreiben die Daten hier ganz gut. Das ist aber keine Selbstverständlichkeit. Und zustätzlich Schiefe und Exsess gebe ich doch auch an. Was willst du mehr?

Du schreibst: "Und es geht auch immer um Vergleichbarkeit."
Die hat man, wenn man die Verteilung genügend genau beschrieben hat.
Wenn man zum Beispiel feststellt, dass man für alle Stichproben die
Ähnlichkeit zur Normalverteilung durch die gleiche Transformation
verbessern kann, ist man weiter.

Ist aber wohl nicht nötig. Clemencon schreibt im verlinkten Papier, dass er sogar den Normalverteilungstest für unnötig hält, da bereits 87% seiner Stichproben normalverteilt seien und man somit einfach von einer Normalverteilung der Grundgesamtheit ausgehen könne.

Du schreibst: "Über Ausreißertests! Sind nur Theorien, aber nicht
widerlegte..."
Die von Dir verwendeten Tests setzen Normalverteilung voraus. Ich habe einen
parameterfreien Schätzer benannt, der braucht aber n > 60. Das sollte
einem zu Denken geben.

Ich weiß jetzt leider nicht mehr, welchen du benannt hast. Median vielleicht, der braucht aber keine n > 60?
Gebe ich ja mit an. Hatte ich auch schon drauf hingewiesen. Findest du in den Grafiken, die ich zeige.

Ich zitiere zum Thema Ausreißer folgende Seite:
https://de.wikipedia.org/wiki/Ausrei ßer
"Liegt ein Ausreißer vor, muss überprüft werden ob es sich bei dem
Ausreißer tatsächlich um ein verlässliches und echtes Ergebnis handelt
oder ob ein Messfehler vorliegt."

Ja, oder Fremdspore, mehrkernige Spore, Mutation, Fehler bei der Eingabe

Auf die Sporen übertragen: Man müsste jede Messung nachvollziehbar machen, um
dieselbe Spore erneut messen zu können.
Dann könnte man prüfen, ob sich Anhaltspunkte ergeben, dass ein Messfehler
vorliegt. Das könnte zum Beispiel durch eine Fremdspore passieren, die man
zum Beispiel durch Betrachten des Ornaments identifizieren könnte.
Dazu kann ich aber keinerlei Erfahrungen beisteuern.

Ja, wenn der Unterschied so simpel erkennbar wäre.

Du schreibst: ""unzureichende Ergebnisse" bringt er für was?
Da fehlt mir der Bezug."
Ich empfinde die Ergebnisse als unzureichend, wenn in der Stichprobe, die Du
auswertest, Werte enthalten sind, die nicht in dem von Dir berechneten
Konfidenzintervall liegen. Bei solchen winzigen Stichprobe, sollte das
nicht passieren.

n ist 30. Wie erkennst du da Werte? Ich sehe im Boxplot einen Wert ausserhalb des 1,5 fachen Interquartilsabstandes. Der wäre auch ohne Verteilungsannahme als Ausreißer anzusehen.

Du schreibst: "Aber was auch immer du da sagen willst, würde mich
interessieren, was du stattdessen angeben würdest?"
Ich würde Min Max Intervalle deiner Stichprobe angeben. Die kann man dann
auch leichter mit anderen Stichproben zusammenfassen.

Damit hättest du als einziges die Spannweite angegeben und hättest keine Möglichkeit, die Stichprobe mit anderen zu vergleichen. Wissenschaftlich gesehen eine Katastrophe! Und noch schlimmer, je mehr du misst, desto wahrscheinlicher sind Werte aus den Randbereichen dabei. Deine Spannweite würde immer größer werden. Du würdest also durch Erhöhung der Stichprobengröße immer ungenauer werden. Genau das will ich nicht. Mittelwertbasierte Tests wären nicht mehr möglich. ANOVA auch nicht.

Du schreibst: "Ich rechne die Ausreisser unter Normalverteilungsannahme.
Ich versuche damit soviel Power wie möglich in erste Ergebnisse zu
bringen."
Wenn Du Ausreißer herausnimmst, von denen Du nicht sicher weißt, dass sie
welche sind, reduziert Du die Aussagekraft deiner Angaben.

Es ist üblich, im Text darauf hinzuweisen, dass Ausreißer nicht mit berechnet wurden. Die Aussagekraft kann präziser werden, weil ich jetzt eine geringere Verschiebung der statischen Kennwerte mehr habe. Und ja, das Mittelwertkonfidenzintervall wird durch kleineres n größer.

Wenn ich vergleichbare Datensätze haben möchte, komme ich um Ausreissertests nicht herum.

Du schreibst: "Ja, und nach vielen Jahren eigener
Erfahrungsammlung"
Für das Messen von je ca. 60 Sporen für 10 Arten brauche ich nicht so lange.
Wenn ich mir ein Programm schreibe, das das macht, kann ich später
beliebige Sporenbilder auswerten.

Du hast vermutlich noch nie Sporen mit dem Mikroskop vermessen. Natürlich benötigt man für 60 Sporen x 10 Arten keine Jahre.
Wenn das so einfach wäre, hätte ich das Programm schon lange geschrieben. Ich hatte doch schon auf ein Beispiel mit ML hingewiesen und extra darauf hingewiesen, dass die Sporen dort rund waren. Zudem haben sie Sporen mittels Ultraschall auf eine Ebene gebracht
Bei uns schwimmen sie mehr oder weniger frei herum und man darf halt nur Sporen messen, die exakt flach in der Fokusebene schwimmen.

"liest du dir dann unseren Thread noch einmal durch und du wirst dich
fragen, wieso du so viel in Frage gestellt hast?"
Die Wahrscheinlichkeit dafür ist gleich 0. Dafür machst Du einfach zu viele
methodische Fehler. So hast Du erklärt, dass Du das Zusammenfassen von
Stichproben aus verschiedenen Quellen für nicht sinnvoll hältst.

Hab ich nicht. Warum auch? Genau dass wäre doch super. Ich habe darauf hingewiesen, dass es für den Vorgang statistische Methoden gibt.

Ohne Papier braucht man ein Grafikprogramm, mit dem man vermessen und bemaßen
kann. Sind schweineteuer und unangenehm zu bedienen: Auf Papier geht es
schneller eine Spore mit einem guten Längenmesser zu messen.

Schneller niemals. Und ich vermeide Eintippfehler bei der Zahleneingabe. ImageJ ist z.B. kostenlos. Oder Piximetrie. Ist auch kostenlos glaube ich.

Du schreibst: "Oder wann erkennst du an, das es einen Unterschied
zwischen endlicher und unendlicher Grundgesamtheit gibt?"
Du hattest erklärt, dass Du mit Theorie für eine endliche Grundgesamtheit
arbeitest.
Ich hatte Dich darauf hingewiesen, dass Du eine unendliche Grundgesamtheit
hast, weil Du Gleitkommazahlen verwendest.

Ich schrieb schon einmal, wenn der Pilz eine Million Sporen aussport, dann ist das eine endlich Grundgesamtheit. Das hat doch mit der späteren Berechnung nichts zu tun. Wohl aber mit der verwendeten Statistik. Und ich könnte auch mit Integerzahlen rechnen und das würde nichts am Ergebnis ändern.

Gruß, Jens
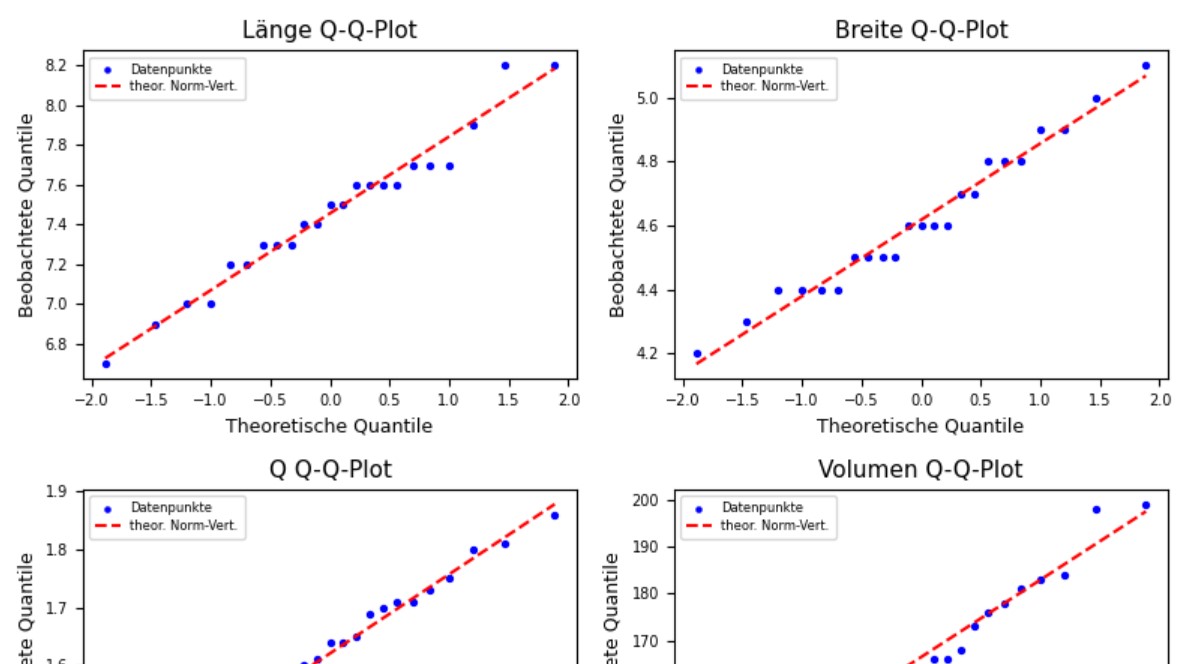
[image]

Re: Falsche Grafik! Richtige Auswertung kommt jetz

lupus, (vor 461 Tagen) @ Krötenhocker

jetzt nochmals und endgültig von mir: ganz normal ist eure "Disskussion" hier aber echt nicht. Auch wenn manche meinen "das Forum lebt". DAS ist kein Leben. Das ist Spinnerei unter Theoretikern, die niemanden interessiert!

Re: Falsche Grafik! Richtige Auswertung kommt jetz

Krötenhocker, (vor 461 Tagen) @ lupus

jetzt nochmals und endgültig von mir: ganz normal ist eure
"Disskussion" hier aber echt nicht. Auch wenn manche meinen
"das Forum lebt". DAS ist kein Leben. Das ist Spinnerei unter
Theoretikern, die niemanden interessiert!

Doch, mich! Die Software, die ich programmiere, kann helfen, Sporenstichproben besser zu verstehen und in Veröffentlichungen fasifizierbare Aussagen zu treffen. Wenn dich das nicht interessiert, so what? Lies es doch einfach nicht. Sporen für Stichproben zu vermessen ist keine Theorie, sondern gängige Praxis.

Re: Normalverteilung

Marcel Weymann, (vor 469 Tagen) @ Krötenhocker

Hallo Jens,
ich gebe bewusst keine Formeln an, in die man einfach nur Zahlen einsetzt.
Um Formeln sinnvoll einsetzen zu können, sollte man sie zunächst vollständig verstehen.
Das wird selbst von Auszubildenden in technischen Berufen erwartet.
Wenn ein Auszubildender im Maschinenbau zum Beispiel glaubt, dass jede Messung eine Schätzung sei, wird er seine Prüfung nicht bestehen.
Von Ingenieuren wird außerdem erwartet, dass sie die Herleitung der Formeln nachvollziehen können.
Das alles aus gutem Grund.
Jeder Techniker kennt folgende Sprüche und hat schon Anwendungsfälle gesehen:
Herr X misst Hausnummern
A fool with a tool is still a fool.
(Ein Narr mit Werkzeug bleibt ein Narr)
Trivialbeispiel: Herr X vermisst sich immer beim Messen mit dem Meter.
Man kauft ihm ein Messgerät mit Laserlängenmessung und hofft vergeblich, dass jetzt keine Fehler mehr passieren.

Ich habe darum ausführlich die beteiligten Zufallsprozesse und Variablen beschrieben, die ich in deinen Vorgaben finde und beschrieben, dass Du erwartungstreue Schätzer mit bekannter Konvergenz brauchst, um das zu erreichen, was Du ereichen willst.
Ich habe Dir das Beispiel der Funktion Limes(n->Unendlich)(n/(n + Konstante)) gegeben.
Für den Fall, dass ich unverständlich schreibe, habe ich Dir Quellen genannt, die dasselbe noch ein Mal in einer anderen Form mit zusätzlichen Informationen bringen.
Ich verstehe darum nicht, warum Du jetzt folgendes schreibst:
"Begründe bitte deine sehr großen Stichproben. Welchen Mehrwert haben sie gegenüber einer Stichprobe aus 50 Messungen? Ja, das Konfidenzintervall wird kleiner.
Wie soll denn "das Konfidenzintervall" kleiner werden?"
Dass Schätzungen bei größerer Stichprobengröße genauer werden, wusste ich schon als Grundschulkind.
Mein Opa war nämlich begeisterter Lottospieler.
Er hatte Tabellen, welche Zahlen im letzten Jahr am häufigsten gezogen wurden und glaubte höhere Gewinnchancen zu haben, wenn er die tippt.
Das war damals eine Stichprobe von ca. 50 Ziehungen im Jahr - = eine Stichprobe mit n = 50 - und man sah da deutliche Unterschiede in der Häufigkeit.
Er hatte aber auch Tabellen über die letzten 10 Jahre - = eine Stichprobe mit n = 500 - und da waren die Unterschiede schon viel kleiner.
Schon als Kind schloss ich daraus, dass seine Stichprobe über 1 Jahr nicht ausreicht, um herauszufinden, welche Zahlen am häufigsten kommen.
Ich habe diese Beispiel mit jemanden besprochen, mit dem ich über mehrere Jahre eine Fahrgemeinschaft hatte. Wir fuhren ein Mal pro Woche von Kaiserslautern nach Offenbach/Main.
Zu seinen Interessensgebieten gehören mathematische Probleme, insbesondere Statistik. Wir haben darum während der Fahrgemeinschaft häufig solche Probleme diskutiert.
Er ist übrigens kein Mathematiker, sondern war Beamter beim Wetterdienst.
Wir treffen uns seit einiger Zeit eher zufällig im Schwimmbad und wir haben diesen Dienstag über diese Diskussion gesprochen.
Er brachte folgendes Beispiel:
Beim Roulette kommt es früher durchaus vor, dass bestimmte Zahlen häufiger kamen als andere. (Auf Grund der Mechanik)
Nun kam es vor, dass Leute mit Hilfe genügend großer Stichproben herausfanden welche und mit dieser Kenntnis Gewinne bei der Spielbank erzielten.
Ich habe dazu eine Quelle gefunden:
https://statmodeling.stat.columbia.edu/2018/08/09/richard-jarecki-doctor-conquered-roul...
Zitat:
"Ms. Jarecki said that watching, or “clocking,” a wheel, as Mr. Barnhart described it, could mean observing more than 10,000 spins over as long as a month.
Sometimes a wheel would yield no observable advantage. But when Dr. Jarecki and company did find a wheel with a discernible bias, he would have an edge over the house.
“It isn’t something he invented,” Ms. Jarecki said. “It’s something he perfected.”
Herr Jarecki hat also eine Stichprobe mit n = 10000 gezogen, um genügend Genauigkeit zu erreichen, damit er Gewinne erzielt.
Die Casinos haben dann dafür gesorgt, dass der Tisch jede Nacht neu aufgesetzt wurde. Damit wanderte der Fehler und Herr Jarecki kam nicht mehr auf das nötige n.
Ich versuche jetzt noch ein Mal das mit deinem Problem zu zeigen:
Du schätzt den Mittelwert der Grundgesamtheit aus einer Stichprobe. Der Mittelwert ist das erste Moment der Grundgesamtheit.
Du hast keine Information darüber, wie genau die Schätzung ist.
Du schätzt aus der Stichprobe weiterhin die Streuung - das zweite Moment. Du weißt nicht, wie genau diese Schätzung ist.
Ich habe mal gelernt, dass das benötigte n mit der Höhe der Momente steigt.
Um zu wissen zu können ab welchem n Du welche Genauigkeit hast, müsstest Du die Wahrscheinlichkeitsfunktion der Grundgesamtheit kennen.
Ein kleines Beispiel:
Es kann zum Beispiel vorkommen, dass eine Stichprobe die Länge einer Spore auf 6 Einheiten schätzt, eine andere auf 8 eine Dritte auf 10.
Es kann auch sein, dass die Schätzung viel besser ist: Du hast dann zum Beispiel Messungen von 8.1, 8.2 und 8.3.

Ohne möglichst genaue Schätzungen über die Grundgesamtheit, weißt Du nichts über deinen zu erwartenden Fehler.
In der Technik arbeitet man gerne mit einem Referenzmessgerät, das viel genauer misst als das Messgerät, das man vor sich hat und kalibriert damit.

Da Du das nicht hast, bleibt Dir nichts anderes übrig, als irgendwie mehr Informationen über die Grundgesamtheit zu bekommen.
Dabei gibt es wie gesagt nur zwei Möglichkeiten:
1. Stichprobe mit großem n
2. Mit Hilfe mehrerer mittelgroßer Stichproben Momente der Grundgesamtheit schätzen.
Möglichst auch noch Schiefe und Wölbung.
Der Haupttreffer im Lotto wäre es, wenn Du herausfinden würdest, dass die Grundgesamtheiten für verschiedene Pilzarten statistische Ähnlichkeiten haben, d.h. die Verteilungsfunktionen sind ähnlich.
Dann könntest Du viel höhere Genauigkeiten deiner Schätzungen erreichen.

Man sollte das Ganze mit einem Zufallsgenerator simulieren, der normalverteilte Zufallsvariable erzeugt.
Das ist aber tückisch.
Der "Informatik Papst" Donald E. Knuth schreibt zum Beispiel in seinen Büchern, dass er zahlreiche akademische Arbeiten gefunden hat, die mit Hilfe solcher Simulationen erzeugt wurden.
In vielen Fällen fand er, dass der verwendete Zufallsgenerator keine normalverteilten zufälligen Zahlen erzeugt.
Er schrieb dann, dass er eigentlich anregen müsste, den Leuten ihre akademischen Titel zu entziehen, es aber nicht getan hat.
Gleichverteilung kann man leicht simulieren. Bei anderen Verteilungen, zum Beispiel solchen mit 2 Maxima, muss man da eine Menge Gehirnschmalz investieren.

Ich pflege seit Anfang diesen Jahres meine 94jährige demente Mutter in Vollzeit.
Ich muss leider sagen, dass man bei täglichem Umgang mit einem dementen Menschen selbst sehr acht geben muss, seine eigene geistige Gesundheit zu erhalten.
Ich habe Sie gestern zum Beispiel zum Zahnarzt gebracht, wo man ihr in einer 2,5 Stunden langen Prozedur ihre drei letzten Zähne gezogen hat.
Sie hatte einen Teil ihres Gebisses in den Müll geworfen und braucht darum ein neues.
Ich musste bei der Behandlung helfen, weil 2 Menschen es nicht geschafft haben, sie genügend ruhig zu halten, weil sie die Schmerzen nicht mehr ertragen konnte.
Ich sehe mich darum leider nicht in der Lage momentan derart kniffliges Zeug zu programmieren.

Noch ein Wort zu den Analysen von Werner Jurkeit:
Er beschreibt alle Merkmale und gibt Hinweise zu deren Variabilität, die überhaupt zur Pilzbestimmung herangezogen werden können.
Das geht von "Ist die Huthaut glänzend?" zu "Wie ist das Sporenornament?"
Er befasst sich sehr genau mit mikroskopischen Merkmalen, von denen ich mir noch nicht einmal die Namen merken kann.
Ich habe zwar ein kleines Latinum, aber das hilft mir da eher nicht.
Ich kann mir nur die Zeichnungen ansehen und versuchen zu verstehen. Da habe ich aber noch viel Arbeit vor mir.

Gruß,
Marcel

Re: Normalverteilung

Krötenhocker, (vor 469 Tagen) @ Marcel Weymann

Hallo Marcel,

ich gebe bewusst keine Formeln an, in die man einfach nur Zahlen einsetzt.
Um Formeln sinnvoll einsetzen zu können, sollte man sie zunächst vollständig
verstehen.
Das wird selbst von Auszubildenden in technischen Berufen erwartet.

Yupp!

Wenn ein Auszubildender im Maschinenbau zum Beispiel glaubt, dass jede
Messung eine Schätzung sei, wird er seine Prüfung nicht bestehen.

Falsch, die Fehlerechnung aufgrund der Ungenauigkeit einer Messung ist Grundlage der Ausbildung eines Technikers. Oh, jetzt hab ich nochmal genau gelesen! Du sprichst vom mathematisch notwendigen Niveau eines Azubis! Der darf natürlich an die Genauigkeit seines "Gliedermaßstabs" oder des "Meßschiebers" glauben.

Von Ingenieuren wird außerdem erwartet, dass sie die Herleitung der Formeln
nachvollziehen können.
Das alles aus gutem Grund.
Jeder Techniker kennt folgende Sprüche und hat schon Anwendungsfälle gesehen:
Herr X misst Hausnummern
A fool with a tool is still a fool.
(Ein Narr mit Werkzeug bleibt ein Narr)
Trivialbeispiel: Herr X vermisst sich immer beim Messen mit dem Meter.
Man kauft ihm ein Messgerät mit Laserlängenmessung und hofft vergeblich, dass
jetzt keine Fehler mehr passieren.

Was bitte hat das mit der Auswertung von Stichproben zu tun?

Ich habe darum ausführlich die beteiligten Zufallsprozesse und Variablen
beschrieben, die ich in deinen Vorgaben finde und beschrieben, dass Du
erwartungstreue Schätzer mit bekannter Konvergenz brauchst, um das zu
erreichen, was Du ereichen willst.

Als erwartungstreuen Schätzer meinst du die Mittelwerte? Wenn ja, wird die Erwartungstreue durch die Konfidenzintervalle und n beschrieben. Und mit wachsendem n auch genauer!
Zudem würde ich gerne erstmal eine Menge Daten sammeln. Also nicht nur für mich.
Bei gentischen Daten klappt das ja auch.

Ich habe Dir das Beispiel der Funktion Limes(n->Unendlich)(n/(n +
Konstante)) gegeben.

Und ich habe dir das Bootstrap-Beispiel dazu gezeigt. Also anstatt am Ende auf 1 kommt man mit sehr vielen Ziehungswiederholungen dem Mittelwert oder den Populationgrenzen näher.

Für den Fall, dass ich unverständlich schreibe, habe ich Dir Quellen genannt,
die dasselbe noch ein Mal in einer anderen Form mit zusätzlichen
Informationen bringen.
Ich verstehe darum nicht, warum Du jetzt folgendes schreibst: "Begründe
bitte deine sehr großen Stichproben. Welchen Mehrwert haben sie gegenüber
einer Stichprobe aus 50 Messungen? Ja, das Konfidenzintervall wird
kleiner.
Wie soll denn "das Konfidenzintervall" kleiner werden?"

Wenn du dir die Formel für das Konfidenzintervall anschaust, wirst du es verstehen. Noch mal genauer: Ich meine das Konfidenzintervall des Mittelwerts.

Dass Schätzungen bei größerer Stichprobengröße genauer werden, wusste ich
schon als Grundschulkind.
Mein Opa war nämlich begeisterter Lottospieler.

Schon wieder machst du den gleichen Fehler! Ich rede hier über und programmiere mit der Mathematik zu endlichen Grundgesamtheiten. Du nicht! Bei mir ist immer n < unendlich!
Deshalb gehe ich auf den jetzt folgenden Abschnitt auch nicht weiter ein. Deshalb also jetzt hier weiter

Ich versuche jetzt noch ein Mal das mit deinem Problem zu zeigen: Du schätzt
den Mittelwert der Grundgesamtheit aus einer Stichprobe. Der Mittelwert
ist das erste Moment der Grundgesamtheit.
Du hast keine Information darüber, wie genau die Schätzung ist.

Wenn ich unter gleichen Bedingungen erneut eine Stichprobe ziehe, dann erwarte ich, dass der neue Mittelwert in der Regel innerhalb oder in der Nähe des vorher berechneten 95 %-Konfidenzintervalls liegt. Das muß erstmal reichen.

Du schätzt aus der Stichprobe weiterhin die Streuung - das zweite Moment. Du
weißt nicht, wie genau diese Schätzung ist.

Genau! Wie ich schon schrieb: Daten Daten Daten!

Ich habe mal gelernt, dass das benötigte n mit der Höhe der Momente steigt.
Um zu wissen zu können ab welchem n Du welche Genauigkeit hast, müsstest Du
die Wahrscheinlichkeitsfunktion der Grundgesamtheit kennen.

Wenn ich die Normalverteilungsfunktion für die Grundgesamtheit annehme, kann n sehr klein bleiben.

Ein kleines Beispiel: Es kann zum Beispiel vorkommen, dass eine Stichprobe
die Länge einer Spore auf 6 Einheiten schätzt, eine andere auf 8 eine
Dritte auf 10.
Es kann auch sein, dass die Schätzung viel besser ist: Du hast dann zum
Beispiel Messungen von 8.1, 8.2 und 8.3.
Ohne möglichst genaue Schätzungen über die Grundgesamtheit, weißt Du nichts
über deinen zu erwartenden Fehler.

Ich nehme i.d.R. Normalverteilung an. Das macht es einfacher und den Fehler präziser eingrenzbar.

Da Du das nicht hast, bleibt Dir nichts anderes übrig, als irgendwie mehr
Informationen über die Grundgesamtheit zu bekommen.

Um mehr Informationen zu bekommen, hatte ich diesen Thread "gekapert". Ich konnte ja nicht ahnen, wie sich das hinzieht nur um mal nachzufragen, ob ich Daten bekommen kann.

Dabei gibt es wie gesagt nur zwei Möglichkeiten:
1. Stichprobe mit großem n

Hier nicht sinnvol. Die Streuung durch andere Einflüsse erfordert mehr Faktoren.

2. Mit Hilfe mehrerer mittelgroßer Stichproben Momente der Grundgesamtheit
schätzen.

Ja

Möglichst auch noch Schiefe und Wölbung.

Das sind Parameter, die man jederzeit aus den originalen Stichproben berechnen kann und wenn du die von mir angehängten Plots anschaust, siehst du die Werte auch. Wölbung habe ich aber mit Kurtosis benamst. Kurtosis = Wölbung - 3. Wird dadurch einfacher vergleichbar.

Der Haupttreffer im Lotto wäre es, wenn Du herausfinden würdest, dass die
Grundgesamtheiten für verschiedene Pilzarten statistische Ähnlichkeiten
haben, d.h. die Verteilungsfunktionen sind ähnlich.
Dann könntest Du viel höhere Genauigkeiten deiner Schätzungen erreichen.

Ja

Man sollte das Ganze mit einem Zufallsgenerator simulieren, der
normalverteilte Zufallsvariable erzeugt.
Das ist aber tückisch.
Der "Informatik Papst" Donald E. Knuth schreibt zum Beispiel in
seinen Büchern, dass er zahlreiche akademische Arbeiten gefunden hat, die
mit Hilfe solcher Simulationen erzeugt wurden.
In vielen Fällen fand er, dass der verwendete Zufallsgenerator keine
normalverteilten zufälligen Zahlen erzeugt.
Er schrieb dann, dass er eigentlich anregen müsste, den Leuten ihre
akademischen Titel zu entziehen, es aber nicht getan hat.
Gleichverteilung kann man leicht simulieren. Bei anderen Verteilungen, zum
Beispiel solchen mit 2 Maxima, muss man da eine Menge Gehirnschmalz
investieren.

Einzelne Arten scheinen (aus eigener Erfahrung) sehr unterschiedlich Mischpopulationen zu bilden. Keine allgemeine Simulation könnte das abbilden.

Ich pflege seit Anfang diesen Jahres meine 94jährige demente Mutter in
Vollzeit.
Ich muss leider sagen, dass man bei täglichem Umgang mit einem dementen
Menschen selbst sehr acht geben muss, seine eigene geistige Gesundheit zu
erhalten.
Ich habe Sie gestern zum Beispiel zum Zahnarzt gebracht, wo man ihr in einer
2,5 Stunden langen Prozedur ihre drei letzten Zähne gezogen hat.
Sie hatte einen Teil ihres Gebisses in den Müll geworfen und braucht darum
ein neues.
Ich musste bei der Behandlung helfen, weil 2 Menschen es nicht geschafft
haben, sie genügend ruhig zu halten, weil sie die Schmerzen nicht mehr
ertragen konnte.

Puuh, konnte man nicht vorher ein Beruhigungsmittel geben? Da wünsche ich dir jedenfalls noch viel Kraft!

Ich sehe mich darum leider nicht in der Lage momentan derart kniffliges Zeug
zu programmieren.

Ich denke, ich bin auf dem richtigen Weg. Auch diese Diskussion hilft!

Noch ein Wort zu den Analysen von Werner Jurkeit: Er beschreibt alle Merkmale
und gibt Hinweise zu deren Variabilität, die überhaupt zur Pilzbestimmung
herangezogen werden können.
Das geht von "Ist die Huthaut glänzend?" zu "Wie ist das
Sporenornament?"
Er befasst sich sehr genau mit mikroskopischen Merkmalen, von denen ich mir
noch nicht einmal die Namen merken kann.
Ich habe zwar ein kleines Latinum, aber das hilft mir da eher nicht.
Ich kann mir nur die Zeichnungen ansehen und versuchen zu verstehen. Da habe
ich aber noch viel Arbeit vor mir.

Ja, die Variabilität ist immer ein großes Problem. Aber mir geht es auch darum, wenn schon alles ziemlich variabel ist, dass es eine Abkehr von herkömmlichen Größenangaben gibt, weil sie nicht falsifizierbar sind und somit nicht dazu benutzt werden können, zukünftig genauere Aussagen treffen zu können oder sogar die Messungen in Frage zu stellen (z.B. systematische Fehler oder andere Art)

VG, Jens

Re: Normalverteilung

Marcel Weymann, (vor 465 Tagen) @ Krötenhocker

Hallo Jens,
Du schreibst:
"Schon wieder machst du den gleichen Fehler! Ich rede hier über und
programmiere mit der Mathematik zu endlichen Grundgesamtheiten. Du nicht!"
Wir hatten uns darauf geeinigt, dass das Thema Sporenmessung ist.
Du behauptest: "Ich rede hier über und
programmiere mit der Mathematik zu endlichen Grundgesamtheiten."
Du setzt Werte in Formeln ein. Das hat mit Mathematik nichts zu tun.
Die Mathematik ist zunächst bei dem Problem die Beschreibung von Zufallsprozessen und die Definition von Zufallsvariablen.
Anschließend beschreibt die Mathematik wie man Schätzer für zum Beispiel Mittelwerte und Streuungen finden kann.
Für die Genauigkeit dieser Schätzer abhängig von n macht die Mathematik bei unbekannter Grundgesamtheit keinerlei Aussagen.
Weil Du die Mathematik nicht verstanden hast, glaubst Du trotzdem Aussagen machen zu können.
Du bringst dafür aber keinerlei Quellen, mit denen Du das begründen könntest.
Ich habe darum versucht Dir die mathematischen Grundlagen näher zu bringen.
Das habe ich auch an Hand von Beispielen aus dem täglichen Leben getan, die einen Bezug zu denselben mathematischen Grundlagen wie das Problem "Sporenmessung" haben.
Bei der Sporengrößen handelt es sich übrigens nicht um eine endliche Grundgesamtheit.
Es gibt unendlich viele Gleitkommazahlen, sogar überabzählbar viele.
Während mein Ex-Fahrgemeinschaftspartner - der übrigens Pilzkenner ist, aber keine akademische Ausbildung hat - sofort das Problem der Stichprobengröße identifiziert hat und ein eigenes Beispiel gebracht hat, betrachtest Du meine Versuche Dir das näher zu bringen, als Abschweifung vom Thema.
Was Du als Fehler betrachtest nennt man wissenschaftliches Arbeiten, man kann auch ingenieursmäßige Herangehensweise dazu sagen.
Wie wenig Du verstanden hast, sieht man wenn Du schreibst, ich käme vom Programmieren.
Ich bin Ingenieur TH der Elektrotechnik.
Man muss für diese Art der Problemlösung aber nicht studiert haben, auch gute Handwerker gehen so vor.
Ich hatte berichtet, dass mir wenige Modelle für biologische Prozesse bekannt seien.
Eines möchte ich hier aber noch nachtragen, um ingenieursmäßige Herangehensweise zu zeigen:
Ein Dozent für Regelungstechnik beobachtete immer wieder eine Amsel, die auf einem Zweig vor seinem Fenster landete.
Irgendwann später erstellte ein Student eine Diplomarbeit über diesen Vorgang aus regelungstechnischer Sicht.
Diese Diplomarbeit könnte durchaus auch für Biologen interessant sein, die zum Beispiel der Frage nach gehen, ob denn das Tier, dessen versteinerte Überreste gefunden wurden fliegen konnte oder ob es vielleicht in Bäumen lebte.
Die wenigsten Biologen haben aber wissenschaftliches Arbeiten wirklich gelernt, deshalb sind sie wie Du auch auf konkrete Lösungen fixiert und weiten ihren Blick nicht genügend.
Das Beste, was ich zur Mykologie gelesen habe, sind die erwähnten Bücher von Werner Jurkeit.
Der schlimmste Text, der als wissenschaftlich bezeichnet wird, den ich kenne, ist übrigens von Charles Darwin "On the origin of species", den ich im Original gelesen habe.
In der Technik würde man so jemanden als Dampfplauderer bezeichnen.
Modernere Texte zu Entwicklung der Arten sind besser, aber auch da fallen mir methodischen Fehler auf.
Ich lese jetzt Shakespeare "Much ado about nothing"
In meinem Studium empfahl nämlich ein Dozent: "Lesen sie Shakespeare"
Er hatte recht, es weitet den Horizont. Man bekommt viele neue Ideen für Problemlösungen.
Gruß,
Marcel

Re: Normalverteilung

Peter, (vor 465 Tagen) @ Marcel Weymann

Hallo Jens und Marcel,

eure fachliche Diskussion habe ich mit Interesse verfolgt. Eure Ansätze sind total verschieden. Ihr werdet keinen Konsens finden – was aber auch nicht nötig ist. Ich hole das mal auf eine allgemein verständliche Ebene.

Häufig werden bei Pilzen 20 Sporen gemessen und aus diesen Maßen die „gefühlte“ Variationsbreite angegeben, z. B. 8-10 x 5-6,5 µm. Ausreißer/Maximalwerte kann man in Klammern davor und dahinter setzen.

Dass Mathematiker damit nicht ganz zufrieden sind, liegt auf der Hand. Man möchte „objektivere“ Zahlen haben. Dazu mathematische Wege der Wahrscheinlichkeitsrechnung/Statistik zu benutzen ist naheliegend. Dies wird auch zunehmend praktiziert, was man an den Angaben in Publikationen ablesen kann. Dann erscheinen in den Ergebnissen außer der Bandbreite mit Nachkommastelle(n) zusätzlich Mittelwerte, Volumenwerte, Q-Werte und anderes mehr.

Der Wille, die Sporenmaße irgendwie exakter fassen zu können, ist die treibende Kraft. Und wenn ein mathematisches Programm in dieser Richtung einen Mehrwert bedeutet, sollte man dieses Instrument nutzen.

Pilze sind "biologische Wesen" und werden nicht allein durch Sporenmaße bestimmt. Man wird ein Intervall (egal wie erstellt) angeben können, in dem sich (normalerweise!) die Sporenmaße bewegen – mehr nicht. Benutzen viele Leute solche Programme, werden die Werte vergleichbarer. Die Genauigkeit dieser Angaben kann (wird?) durch Smaff oder ähnliche Programme verbessert werden.

Aber eines sollte nicht in Vergessenheit geraten: Um Pilze sicher bestimmen zu können ist die Gesamtheit der Merkmale nötig und nicht allein die Sporenmaße.

Gruß
Peter

PS: „Die wenigsten Biologen haben aber wissenschaftliches Arbeiten wirklich gelernt…“ Diesen und weitere „markige“ Sprüche möchte ich nicht kommentieren. Im Leben muss man sich entscheiden, etwas „machen“ zu wollen oder beim „Kritisieren“ zu bleiben.

Re: Normalverteilung

Krötenhocker, (vor 465 Tagen) @ Peter

Hallo Peter,

ich glaube auch nicht mehr an einen Konsens. Konsens wäre aber auch nicht nötig, wenn sinnvolle Ideen vorhanden wären. So muß ich mir alle Ideen alleine anlesen oder aus den "Fingern saugen". Wenn ich nicht dikutiere, bleibe ich auf "meinem Mist" sitzen. Das regt die gestalterische Ideengebung nicht gerade an.

Häufig werden bei Pilzen 20 Sporen gemessen und aus diesen Maßen die
„gefühlte“ Variationsbreite angegeben, z. B. 8-10 x 5-6,5 µm.
Ausreißer/Maximalwerte kann man in Klammern davor und dahinter setzen.

Ja, "gefühlt" ist null biologisch wissenschaftlich. Ich hatte es schon geschrieben. Die Angaben sind nicht falsifizierbar, also nicht widerlegbar. So gesehen eben nur rein unterhaltend und damit man mal eine Richtung vorgibt.
Wenn man sich statistisch einliest, wird übrigens Ausreißer und Maximalwert wild durcheinander publiziert und in der Regel nicht unterschieden. Ich differnziere da: Ausreißer ist durch Ausreißertests erkannt. Maximalwert ist ein Wert ausserhalb der Populationsgrenzen, welcher nicht durch Ausreißertests als Ausreißer erkannt wurde.

Dass Mathematiker damit nicht ganz zufrieden sind, liegt auf der Hand. Man
möchte „objektivere“ Zahlen haben. Dazu mathematische Wege der
Wahrscheinlichkeitsrechnung/Statistik zu benutzen ist naheliegend. Dies
wird auch zunehmend praktiziert, was man an den Angaben in Publikationen
ablesen kann. Dann erscheinen in den Ergebnissen außer der Bandbreite mit
Nachkommastelle(n) zusätzlich Mittelwerte, Volumenwerte, Q-Werte und
anderes mehr.

Ja, richtig. Aber bei vielen Publikationen ist das nicht viel besser als, statt wie in deinem Beispiel 8-10 µm, jetzt 8-9-10 µm anzugeben. Es fehlt fast grundsätzlich die Verteilungsannahme und die Standardabweichung (oft SD = Standard Deviation) genannt. Oft ist der Mittelwert auch nicht in der Mitte der Angaben, was schon mal die Normalverteilung aus welchen Gründen auch immer ausschliesst. Wenn man die Populationsgrenzen und den Mittelwert und n angibt, kann man (wenn man das Populationsniveau (also z.B. 95%) auch mit angibt, auf die meisten wichtigen Werte für zukünftige Berechnungen zurückrechnen. Also z.B. die Variation oder das Konfidenzintervall des Mittewertes.
Wofür macht man die Angabe von Q und Volumen? Wenn man damit eine mathematische Vergleichbarkeit möglich machen möchte, fehlen, wie oben angegeben, die beschreibenden Variablen. Das ist ein Grund, warum ich in der Datenbank gerne die kompletten Datensätze hätte. Samff in der jetzigen Version schmeißt auch keine Daten mehr raus (Ausreißertests). Sie werden getrennt angegeben, aber eben nicht mit berechnet. Natürlich kann man auch alle Daten des jeweiligen Datensatzes berechnen lassen. Man muß die Aureißer ja immer noch manuell ausschließen. Ich habe übrigens Datensätze von Andreas G., welche trotz Ausreißern schon als normalverteilt angesehen werden. Spannend!
Aber ich kann nicht alles auf einmal machen. Ich werde versuchen, ein Werkzeug bereit zu stellen, welches auch Mittelwertvergleiche und ANOVA und ? ermöglicht, um Unterschiede in den Messreihen falsifizierbar beschreibbar zu machen.

Der Wille, die Sporenmaße irgendwie exakter fassen zu können, ist die
treibende Kraft. Und wenn ein mathematisches Programm in dieser Richtung
einen Mehrwert bedeutet, sollte man dieses Instrument nutzen.

Das ist nett gesagt. Das bisherige Smaff wird jedenfalls fast nirgendwo benutzt. Sonst würden die publizierten MaßAngaben nicht so dermaßen unerklärbar oder eben schlecht beschrieben bleiben.

Pilze sind "biologische Wesen" und werden nicht allein durch
Sporenmaße bestimmt. Man wird ein Intervall (egal wie erstellt) angeben
können, in dem sich (normalerweise!) die Sporenmaße bewegen – mehr nicht.
Benutzen viele Leute solche Programme, werden die Werte vergleichbarer.
Die Genauigkeit dieser Angaben kann (wird?) durch Smaff oder ähnliche
Programme verbessert werden.

Genau! Aber diesmal werde ich mit Smaff versuchen, die Daten auch zu sammeln. Die DGfM wollte mir keinen Teil einer Datenbank zur Verfügung stellen. Ich werde es selber machen müssen.

Aber eines sollte nicht in Vergessenheit geraten: Um Pilze sicher bestimmen
zu können ist die Gesamtheit der Merkmale nötig und nicht allein die
Sporenmaße.

Ja, die gesamte Morphologie und die Erfahrung spielen, wie auch die Genetik die wichtigste Rolle. Smaff kann nur dabei helfen, die Messdaten besser zu verstehen , einzuordenen und faslifizierbare Aussagen in Publikationen zu ermöglichen. Und natürlich zukünftige Fragen zu beantworten, wenn die Datenbank mit ihrer Datengrundlage das ermöglicht.

Es geht ja auch noch um andere Daten. Basidien oder Zystiden oder ... Wenn man sie falsifizierbar beschreiben möchte, braucht man die Statitik. Sonst kann man später nur pseudowissenschaftlich Behauptungen aufstellen, wie: a ist größer als b. Sofern a und b nicht korrekt vorher geschätzt wurden, macht das keinen Sinn. Denn wir reden hier nie über absolute Grenzen. Dafür müsste man immer Alle messen. Wir reden hier über den Umgang mit Stichproben.

VG, Jens

Re: Normalverteilung

Marcel Weymann, (vor 463 Tagen) @ Peter

Hallo Peter,
Du schreibst:
"Häufig werden bei Pilzen 20 Sporen gemessen und aus diesen Maßen die „gefühlte“ Variationsbreite angegeben, z. B. 8-10 x 5-6,5 µm.
Danke für die Information, dass 20 eine häufig verwendete Stichprobengröße ist.
Du schreibst weiter:
"Dass Mathematiker damit nicht ganz zufrieden sind, liegt auf der Hand. Man möchte „objektivere“ Zahlen haben."
Den Mathematikern ist das völlig egal. So lange jemand nur ein Gefühl ausdrückt, hat das mit Mathematik nichts zu tun.
Wenn einer Rechnungen mit dem Computer ausführt, wird der Mathematiker prüfen, ob die Rechnung sinnvolle Werte ergibt und eventuell prüfen, ob zum Beispiel die numerische Mathematik der Gleitkommazahlen nicht zu groben Fehlern geführt hat.
Ein Informatiker wird unter Umständen prüfen, ob der programmierte Algorithmus tatsächlich in der Lage ist, das algorithmische Problem zu lösen.
Ein Systemtheoretiker wird prüfen, ob die Realität - wie zum Beispiel die Sporenmessung - richtig abgebildet ist.
Welches Modell wird durch die verwendeten Formeln beschrieben? Kann das ihnen zu Grunde liegende Systemmodell in genügender Genauigkeit auf den realen Prozess abgebildet werden?

Nun ist es aus wissenschaftlicher Sicht nicht hilfreich, wenn jeder seine eigene Methode hat, eine Variationsbreite anzugeben.
Jens macht zunächst einmal etwas Verdienstvolles. Er möchte eine Methode definieren, die alle verwenden sollen.
Er preist seine Methode damit an, dass er nur eine in der Technik ungemein verbreitete Methode in die Mykologie übertrage.
Eine Methode zu definieren, die alle verwenden sollen, ist durchaus eine bewährte Methode sowohl in der Wissenschaft als auch in der Technik.
Sie hat aber auch Ihre Tücken.
Die Methode muss zunächst exakt beschrieben werden. In seinem Fall gibt es nur - so weit ich weiß - nur ein Programm als Referenz.
So etwas kenne ich in der Technik nur von der Firma Winzigweich. Die bauen eine Version für ihr Windows und der Rest der Welt kann raten, was die denn konkret getan haben.
Es gibt aber auch Normen, die mathematisch fehlerhafte Berechnungen definieren. Beispiel: Fertigpackungsverordnung
Der Techniker fragt sich zunächst einmal: Was möchte ich erreichen?
Der Techniker denkt sich der Teil der Verordnung, der Grenzen festsetzt, soll dem Verbraucher erlauben, sich ein Bild von dem zu machen, was er kauft.
Leider definiert aber die europäische Verordnung, dass eine "doppelte Rundung" stattfindet. In einer Rechnung wird zwei Mal gerundet.
Damit bekommt der Verbraucher etwas anderes als er erwartet.

Nun wieder zur "Norm", die Jens definieren möchte:
Jens errechnet zunächst einmal Mittelwert und Streuung, wobei ich beim Mittelwert noch nicht einmal weiß, ob er den Mittelwert über den Median schätzt.
Mit diesen Werten kann ein Auswerter, dem die Begriffe bekannt sind, etwas anfangen.
Man kann auch hoffen, dass die geschätzten Werte irgendwie in der Nähe der Werte der Grundgesamtheit liegen.
Das von ihm angegebene Konfidenzintervall wird hingegen in der Technik nirgendwo verwendet und das aus gutem Grund.
Es gibt keinerlei Schlüsse, die man aus dem Intervall ziehen kann, wenn es für eine kleine Stichprobe ermittelt wurde.
Der Auswerter könnte hingegen mit Minimal und Maximalwerten etwas anfangen.
Wenn man die noch in Relation mit der Streuung setzt, gewinnt ein genügend geübter Mensch einen Eindruck davon, ob zwei Stichproben zur selben Grundgesamtheit gehören.

Du schreibst:
"Man wird ein Intervall (egal wie erstellt) angeben können, in dem sich (normalerweise!) die Sporenmaße bewegen – mehr nicht."
Das einzige Intervall, das man sinnvoll angeben kann, ist das zwischen Min und Maxwert der eigenen Stichprobe.
Du schreibst:
"Benutzen viele Leute solche Programme, werden die Werte vergleichbarer.
Die Genauigkeit dieser Angaben kann (wird?) durch Smaff oder ähnliche Programme verbessert werden."
Die Genauigkeit der Angaben zu Mittelwert und Streuung kann verbessert werden, wenn verschiedene Stichproben verwendet werden, um bessere Schätzer für Mittelwert und Streuung der Grundgesamtheit zu erhalten.
Dabei ist es gleichgültig, ob verschiedene Menschen Stichproben machen, dieselben Menschen Stichproben vom verschiedenen Myzeln, dieselben Menschen Stichproben vom selben Myzel aus verschiedenen Jahren nehmen,
ob dieselben Menschen mit unterschiedlichen Präperationstechniken Messungen machen usw.
Du schreibst:
"Aber eines sollte nicht in Vergessenheit geraten: Um Pilze sicher bestimmen zu können ist die Gesamtheit der Merkmale nötig und nicht allein die Sporenmaße."
Ein wissenschaftliche Ansatz ist es zunächst alle denkbaren Merkmale anzugeben und auf Messungenauigkeiten bei jedem Merkmal hinzuweisen.
Wie es Werner Jurkeit zum Beispiel in vorbildlicher Weise getan hat.
Wenn man für jedes Merkmal statistische Auswertungen hat, kann man schätzen, mit welcher Wahrscheinlichkeit ein gefundener Fruchtkörper zu einer Art gehört.
Darum meine Beispiele aus der KI.
Die macht genau so etwas automatisiert. KI braucht aber dafür sehr viele Daten.
Da es aber viel mehr eindeutig bestimmte Katzenbilder als Pilzbilder gibt, funktioniert das bei Pilzen noch eher schlecht.
Bei "Pilzbestimmungs-KI" hat man noch das Problem, dass man Datenmaterial braucht, aus dem man alle Merkmale zumindest schätzen kann.
Abgesehen von den Fällen, in denen auf einem Bild zum Beispiel die Stielbasis nicht zu sehen ist, kann das Bild leider keinen Geruch wiedergeben.
Pilzbestimmungsprogramme bauen im übrigen auch Regeln ein: Zum Beispiel: Wenn der Pilz einen Ring hat, ist es mit Wahrscheinlichkeit 1 in Europa kein Täubling.
Dieses Regelwerk verhält sich ähnlich wie die allseits bekannten Bestimmungsschlüssel.

Nun noch eine letzte Abschweifung, um zu zeigen, wodurch Abschweifungen helfen:
Mein letzter Arbeitgeber verbaute Volumenscanner für die Kunden, die Pakete transportieren.
Diese messen Länge, Breite und Höhe.
Und was hat das jetzt mit Sporenmessung zu tun?
Da will man Länge, Breite und Höhe von Sporen messen.
Der Volumenscanner macht ein oder mehrere Fotos, und ermittelt aus diesen Fotos die Abmessungen eines Quaders.
Dem Volumenscanner ist es egal, welchen Maßstab das Foto hat. Damit ist es egal ob man da μm oder cm messen will.
Man wird den Quader durch ein Ellipsoid ersetzen müssen und in irgendeiner Art und Weise die Sporen im Bild finden müssen.
Exakte Mikrozeichnungen wie die von Werner Jurkeit könnten dabei helfen.
Gruß,
Marcel

Re: Normalverteilung

Krötenhocker, (vor 463 Tagen) @ Marcel Weymann

Hallo Marcel,

ich verstehe nicht, warum du nicht in bestehender Diskussion MIR antwortest, sondern mit Peter einen "Nebenschauplatz" aufmachst!
Das hilft keinem weiter und zerfasert weiter deine Aussagen und ich und alle anderen Lesenden lernen nichts dazu. Wenn du wirklich etwas Konkretes zur Thematik beizutragen hast, dann würde ich und bestimmt alle Mitlesenden mich freuen, es lesen zu können! Damit meine ich, bitte antworte auf meine Fragen und Aussagen.
Warum sollte sich Peter mit dir auseindersetzen, wenn du noch nicht einmal bei mir antwortest? Jeder kann lesen, wie du vorgehst und es fällt zunehmend schwerer, deine Theorien mit der Realität in Einklang zu bringen. Ja, deine Beispiele kommen womöglich aus der Realität, haben aber mit dem hier Diskutierten nichts zu tun. Bleib doch einfach mal bei diesem Thema und wenn du etwas nicht nachvollziehen kannt, frag mich!

Peter, dich wollte ich natürlich nicht von einer Antwort befreien. Ich hoffe, ich habe auch in deinem Namen gesprochen.

VG.Jens

Re: Normalverteilung

Marcel Weymann, (vor 463 Tagen) @ Krötenhocker

Hallo Jens,
Peter hatte uns beide angesprochen.
Du hast ihm geantwortet.
Jetzt beschwerst Du Dich darüber, dass ich dasselbe getan habe.
Fällt Dir da nicht irgend etwas auf?
Ich antworte auf die, die mich adressiert haben, in der Reihenfolge des Eingangs.
Ich brauche dazu allerdings Zeit. Du stellst mir Fragen, die ich schon als Kind beantworten konnte und verstehst dann meine Antworten nicht.
Ich gehe Literaturhinweise, Du befasst Dich nicht damit.
Wenn jemand festgefügte Ansichten hat und sich mit Dingen nicht befassen will, die diese in Frage stellen, gehen jedem irgendwann die Handlungsmöglichkeiten aus.
Unfreundliche Ansprache beschleunigt auch nichts.
Gruß,
Marcel

Re: Normalverteilung

Krötenhocker, (vor 462 Tagen) @ Marcel Weymann

Hallo Marcel,

Du stellst mir Fragen, die ich schon als
Kind beantworten konnte und verstehst dann meine Antworten nicht.

Ich versuche gerade herauszufinden, welche Fragen ich gestellt habe, welche du schon als Kind beantworten konntest?
Ganz schön überheblich! Was ich verstehe, ist dass du mir den Beweis des Grenzwertsatzes näher bringen willst? Warum? Oder deine Glücksspieltheorien. Warum sollte ich auf so etwas antworten? Was hat das mit Stichproben zu tun, aus welchen man Mittelwerte, Konfidenzintervalle und Populationsgrenzen schätzt? Und genau dabei sind deine Antworten nicht zielführend.

Mein konkretes Problem mit deinen Auslassungen: Deine Antworten sind kein Feedback oder Kritik auf meine Einlassungen. Du schweifst grundsätzlich ab. Du könnstest ja mal anfangen, einzelne Anworten meinerseits zu zitieren, damit überhaupt klar wird, wörüber gerade geredet wird. Hast du am Anfang auch mal gemacht! Dann hast du es leider versäumt, genau dabei zu bleiben.

Ich gehe Literaturhinweise, Du befasst Dich nicht damit.

Erwartest du ernsthaft dass ich die bei dir vorhandene Literatur beschaffe, um deine unkonkreten Aussagen zu prüfen?

Wenn jemand festgefügte Ansichten hat und sich mit Dingen nicht befassen
will, die diese in Frage stellen, gehen jedem irgendwann die
Handlungsmöglichkeiten aus.

Genau! Und deshalb zitiere ich jetzt einmal so, wie ich mir wünschen würde, dass auch du so aus deiner Literatur zitierst und nicht einfach mal ein Buch in den Raum wirfst!

Zu deiner Idee, dass Stichproben sehr groß dein müssen:

Kaiser,Dr. R. E. & Mühlbauer, J. A. (1986) - Elementare Tests zur Beurteilung von Meßdaten:

"Es ist ein weitverbreiteter Irrtum, dass erst sehr viele
Messungen brauchbare statistische Aussagen zulassen.
Verschiedene Faktoren, wie z.B. die Reproduzierbarkeit der
Messungen, des gewählten statistischen Versuchsplans und
des benutzten Testverfahrens bestimmen aber die Brauchbarkeit
der Aussagen. Die von uns vorgestellten Verfahren
sind auch unter dem Aspekt ausgesucht worden, dass bei
geringer Anzahl von Messungen "gute" Aussagen ermoeglicht
werden."

Diesem Irrtum scheinst auch du aufgessen zu sein.

Zu meiner Vorgehensweise der deskriptiven Statistik:

Rumsey, Deborah - Übungsbuch Statistik für Dummies (2008):

"Teil III: Schätzungen und Konfidenzintervalle
Ein großer Teil der Statistik beschäftigt sich damit, auf Basis einer Stichprobe Rückschlüsse
auf die Grundgesamtheit zu ziehen. Dazu wird die Lage von bestimmten Parametern wie die
des Mittelwertes in der Grundgesamtheit geschätzt und Konfidenzintervalle berechnet. Das
ist kein Hexenwerk, sondern sehr einfach zu erlernen, wie Sie in diesem Teil sehen werden."

Zur Normalververteilungsannahme:

Clemencon, H. - Von Sporen, Histogrammen und Ellipsen (online und hatte ich schon in diesem Thread verlinkt):

"Prüfung auf Normalverteilung – Eine Notwendigkeit?
Die Forderung nach Normalität der Grundgesamtheit darf nicht allzu streng genommen werden.
Abweichungen sind an der Tagesordnung, aber sie sind in der Regel so klein, dass die Grundgesamtheit
als normalverteilt angenommen werden darf. Parmasto et al. (1987: 19) hielten fest dass
“According to our observations the spore sample of one specimen usually reveals the normal distribution
of measurements (Gemäß unserer Beobachtungen zeigt eine Sporen-Stichproben eines Individuums
eine Normalverteilung der Messungen)”. Dies kann ich anhand von 16 eigenen Untersuchungen
bestätigen (von insgesamt 263 geprüften Stichproben sprachen deren 229 (= 87%) nicht
gegen eine Normalverteilung der Grundgesamtheit). Es darf in der Regel angenommen werden,
dass die Sporen eines Sporenpulvers, genauer gesagt deren Längen und Breiten, etwa normal
(“genügend normal”) verteilt sind. Überraschenderweise sind die Q-Werte (Länge/Breite) bisweilen
nicht normalverteilt, trotz der Normalität der Längen und Breiten. Das spielt aber bei den zweidimensionalen
Längen-Breiten-Streudiagrammen keine Rolle und darf in diesem Zusammenhang
ohne weiteres vergessen werden.
Angesichts der Tatsache, dass mit großer Wahrscheinlichkeit (etwa 85-90%) ein Sporenpulver normalverteilt
ist, geht man kein großes Risiko ein, wenn auf eine Prüfung auf Normalverteilung
verzichtet wird. Und wenn, was was immerhin möglich ist, die Grundgesamtheit der Sporen von der
Normalverteilung abweicht, so ist die Abweichung meist unbedeutend und beruht auf anormal
kleinen oder großen Sporen, die ausgeschlossen oder einfach ignoriert werden können. Solche
Stichproben dürfen wie gewohnt ausgewertet werden. Und wenn damit etwas nicht recht in Ordnung
ist, so weichen die Schlussresultate so wenig von der Realität ab, dass die Abweichungen
keine biologische Bedeutung haben."

Das sind seine Erfahrungswerte. Ich versuche da in der Software genauer zu sein, um fasifierzierbare Aussagen zu ermöglichen. Diese sollte eine möglichst hohe Teststärke haben.
Wenn es nicht klappt, dann eben eine Teststärkestufe niedriger.

Übrigens sind meine Zitathinweise in ein paar Threads vorher von Groß z.B. alle in Zobodat.at einsehbar. Wenn du dich nicht in die Materie "Stichproben bei Sporenmessungen" einliest brauchen wir nicht mehr weiter zu diskutieren. Ich sage es noch einmal, in dem Thema bin ich drin! Du versuchst immer noch das Rad hier neu zu erfinden. Deine Ansätze mit Simulationen z.B. sind hier nicht zielführend. Jede Stichprobe einer anderen Aufsammlung der gleichen Art unterscheidet sich meist ein wenig. Aber auch das scheint artabhängig zu differenzieren und intraartspezifisch von äußeren Bedingungen abhängig zu sein. Dadurch wird man kaum allgemeingültige mathematische Formeln finden können, welche explizit für eine Art gelten. Aber man könnte Konfidenzintervalle oder Populationsgrenzen errechnen, welche die Messungen in der Art abhängig von anderen Faktoren mit einer großen Wahrscheinlichkeit widerspiegeln und dann vergleichbarer machen. Und man könnte dann über t-Tests die Arten womöglich über ihre Sporengrößen differenzieren oder andere messtechnisch erfassbare Merkmale differenzieren.
Über die Arten, welche eine komplette Vermischung von Grundgesamtheiten in der Sporenpopulation haben, reden wir dann in einem neuen Thema.

Gruß, Jens

Re: Normalverteilung (Jetzt wird es fast lustig..)

Krötenhocker, (vor 465 Tagen) @ Marcel Weymann

Hallo Marcel,

Du schreibst: "Schon wieder machst du den gleichen Fehler! Ich rede hier
über und
programmiere mit der Mathematik zu endlichen Grundgesamtheiten. Du
nicht!"
Wir hatten uns darauf geeinigt, dass das Thema Sporenmessung ist.
Du behauptest: "Ich rede hier über und
programmiere mit der Mathematik zu endlichen Grundgesamtheiten."

Und da bleibe ich auch bei!

Ein Pilzfruchtkörper einer Aufsammlung hat n Sporen. n ist vielleicht, je nach Größe des Fruchtkörpers und der Art zwischen geschätzt 1000 und 10e7, vielleicht ja sogar noch mehr. Aber nie ist n gegen Unendlich. Also bleibt es in der Statistik bei endlichen Grundgesamtheiten, über die ich Aussagen treffen kann. Nicht mehr und nicht weniger. Da die Aussagen, da ich in der Regel nicht alle Sporen dieser Grundgesamtheit messen kann, auf einer Stichprobe basieren, kann ich die Grundgesamtheit damit nur schätzen. Das mache ich nach anerkannten Regeln. Was ist daran deiner Meinung nach nicht richtig?

Du setzt Werte in Formeln ein. Das hat mit Mathematik nichts zu tun.
Die Mathematik ist zunächst bei dem Problem die Beschreibung von
Zufallsprozessen und die Definition von Zufallsvariablen.
Anschließend beschreibt die Mathematik wie man Schätzer für zum Beispiel
Mittelwerte und Streuungen finden kann.

Ja, und da ich die Streuung, auf Basis der t-Verteilung (weil ich ja nicht alle messen kann) schätze, hat das warum mit Mathematik nichts zu tun? In meinem Studium FH hieß das Fach "Angewandte Mathematik". Wie hättest du es nach deiner Mathematikvorstellung genannt?

Für die Genauigkeit dieser Schätzer abhängig von n macht die Mathematik bei
unbekannter Grundgesamtheit keinerlei Aussagen.

Neee, aber es gibt Theorien, wie man damuit umgehen kann. Die müssen wir doch nicht neu erfinden! Gauss, Galton (Binominal), Pearson (Gamma-Verteilung), Weibull seien hier nur als Beispiele der Annäherung an eine Verteilungsannahme genannt. Und dann kann ich damit wieder "Zahlen in Formeln einsetzen" ;-)

Weil Du die Mathematik nicht verstanden hast, glaubst Du trotzdem Aussagen
machen zu können.

Hier räusper' ich mich mal kurz.

Du bringst dafür aber keinerlei Quellen, mit denen Du das begründen könntest.
Ich habe darum versucht Dir die mathematischen Grundlagen näher zu bringen.
Das habe ich auch an Hand von Beispielen aus dem täglichen Leben getan, die
einen Bezug zu denselben mathematischen Grundlagen wie das Problem
"Sporenmessung" haben.

Nein, hast du nicht! Du theoretisierst, wenn es ans Eingemachte geht und du schweifst in deine persönlichen Eerfahrungen ab, wenn du nach Beispielen suchst.

Bei der Sporengrößen handelt es sich übrigens nicht um eine endliche
Grundgesamtheit.
Es gibt unendlich viele Gleitkommazahlen, sogar überabzählbar viele.

Aber, wie schon oben beschrieben, gibt es nur endlich viele Sporen, die ich mit weniger Nachkommastellen beschreiben kann.

Während mein Ex-Fahrgemeinschaftspartner - der übrigens Pilzkenner ist, aber
keine akademische Ausbildung hat - sofort das Problem der Stichprobengröße
identifiziert hat und ein eigenes Beispiel gebracht hat, betrachtest Du
meine Versuche Dir das näher zu bringen, als Abschweifung vom Thema.

Supi, welches Beispiel? Aah, ich habe noch einmal nachgeschaut. du meist bestimmt dieses:

"Er ist übrigens kein Mathematiker, sondern war Beamter beim Wetterdienst.
Wir treffen uns seit einiger Zeit eher zufällig im Schwimmbad und wir haben diesen Dienstag über diese Diskussion gesprochen.
Er brachte folgendes Beispiel:
Beim Roulette kommt es früher durchaus vor, dass bestimmte Zahlen häufiger kamen als andere. (Auf Grund der Mechanik)
Nun kam es vor, dass Leute mit Hilfe genügend großer Stichproben herausfanden welche und mit dieser Kenntnis Gewinne bei der Spielbank erzielten.
Ich habe dazu eine Quelle gefunden:
https://statmodeling.stat.columbia.edu/2018/08/09/richard-jarecki-doctor-conquered-roul..."

Du redest hier über Glückspieltheorie! Was hat die Mathematik des Zufalls beim Glücksspiel mit der hier diskutierten Datenanalyse von biologischen Stichproben zu tun? Ich sage es dir: NIX!

Was Du als Fehler betrachtest nennt man wissenschaftliches Arbeiten, man kann
auch ingenieursmäßige Herangehensweise dazu sagen.

Kannst du bitte einmal präzisieren, was du verstanden hast, was ICH als Fehler betrachte? Und genauer noch, was du dann als wissenschaftliches Arbeiten betrachtest?

Wie wenig Du verstanden hast, sieht man wenn Du schreibst, ich käme vom
Programmieren.
Ich bin Ingenieur TH der Elektrotechnik.

Du scheinst nicht zu wissen, was du selbst behauptet hast! Deshalb werde ich meine Aussage dazu noch präzisieren! Du schriebst:

"Hallo lieber Jens,
zunächst einmal möchte ich Dir sagen, dass es eine verdienstvolle Arbeit ist, solche Programme zu schreiben.
Ich möchte weiterhin etwas zu meinem Hintergrund sagen:
Ich bin seit dem 1.1.2025 in Rente und habe vorher 36 Jahre als Softwareentwickler gearbeitet.
Zuletzt im Maschinenbau."

Softwareentwickler??? Also hat bei dir wahrscheinlich Softwareentwicklung geanausowenig mit Programmieren zu tun, wie deine Vorstellung von der Anwendung von Formeln mit Mathematik? Ich rede hier nicht über theoretische Mathematik. Da bin ich raus und du gewiss auch.
Auf welches Niveau möchtest du mich hier eigentlich stellen?

Man muss für diese Art der Problemlösung aber nicht studiert haben, auch gute
Handwerker gehen so vor.

Auch hier bleibt ein leerer Satz stehen. Der Sinnzusammenhang zu egal welcher Aussage fehlt. Für die Leser hier: Lest bitte den Gesamtkontext von Marcel dazu und wenn mir jemand im Verständnis des Geschriebenen weiter helfen kann. Gerne! Ich verstehe lieber, als das ich Fragen stellen muß. Das wäre aber eher Goethe gewesen (versteht man erst unten).

Ich hatte berichtet, dass mir wenige Modelle für biologische Prozesse bekannt
seien.
Eines möchte ich hier aber noch nachtragen, um ingenieursmäßige
Herangehensweise zu zeigen: Ein Dozent für Regelungstechnik beobachtete
immer wieder eine Amsel, die auf einem Zweig vor seinem Fenster landete.
Irgendwann später erstellte ein Student eine Diplomarbeit über diesen Vorgang
aus regelungstechnischer Sicht.
Diese Diplomarbeit könnte durchaus auch für Biologen interessant sein, die
zum Beispiel der Frage nach gehen, ob denn das Tier, dessen versteinerte
Überreste gefunden wurden fliegen konnte oder ob es vielleicht in Bäumen
lebte.

Naja, landen konnte die Amsel nur, wenn sie vorher irgendwo abgesprungen oder abgeflogen ist, sofern sie nicht dahin geworfen wurde oder in einer Zeitschleife fest saß.

Die wenigsten Biologen haben aber wissenschaftliches Arbeiten wirklich
gelernt, deshalb sind sie wie Du auch auf konkrete Lösungen fixiert und
weiten ihren Blick nicht genügend.

Das ist eine ziemlich anmaßende Unterstellung. Ja..., das lass ich mal so stehen. Nee, doch nicht! Ich bin ja auf die konkete Lösung fixiert! Das stimmt!

In meinem Studium empfahl nämlich ein Dozent: "Lesen sie
Shakespeare"
Er hatte recht, es weitet den Horizont. Man bekommt viele neue Ideen für
Problemlösungen.

Ich glaube nicht, dass Shakespeare hier in dieser Problematik den Horizont weiten kann, aber da lass mich gerne von deinen neuen Ideen inspirieren...

Gruß, Jens

Re: Ein rel. wenig kartierter Pilz

coco, (vor 484 Tagen) @ Krötenhocker

Hallo Jens,

Ach ja, wenn sich deine Röhrlingssporen wie Konglomerate anfühlen, könnte das
auch an Heterosporie liegen. Meine erste Idee wäre dann, so viele Sporen
zu messen, dass man eine Mehrgipfeligkeit der Verteilung erkennen kann und
dann in den "Tälern" die Daten zu trennen. Ich glaube, dass ist
mit Signifikanztests möglich.

genau das versuche ich in der Praxis. Die Mehrgipfeligkeit z.B. wenn Morcheln massenhaft Verpeln enthalten, ist schön anzusehen und zu interpretieren. Wenn nun aber vier oder fünf Arten im "Steinpilzpulver" sind, sagen wir Körnchen-Röhrlinge, Austern-Seitlinge, Zucht-Egerlinge, ein Becherling und Steinpilze, wird es knifflig, gerade bei Überschneidungen in den Sporenmaßen. Da hilft mir nur weiter, Lamellen- oder Huthautfragmente zu finden, die weitgehend nur Mikromerkmale eines Typs zeigen. Diese wilden Mischungen meinte ich mit der KI-Idee.

Die Diskussion zwischen Marcel und dir verfolge ich ohne jede Sachkenntnis, aber mit Genuss am kultivierten Diskurs.

LG Coco

Re: Ein rel. wenig kartierter Pilz

Krötenhocker, (vor 484 Tagen) @ coco

Hallo Coco,

wenn du die Messwerte plottest (Scatterplot, ääh.. Punktdiagramm), kannst du dann keine Gruppierungen erkennen? Auch wenn es Überschneidungen gibt, kann man vielleicht trotzdem mehrere unterschiedliche Häufungen erkennen. Und wenn du morphologisch vorsortieren kannst? Becherling z.B. kein Apikulus. Egerling braune Sporen. Austernseitling kleine hyaline, beim Körnchenröhrling müsste ich jetzt nachschauen, B.edulis scheint dann allerdings eh tricky zu sein. Aber es gibt ja auch noch den Sommersteinpilz. Eigentlich sollte man sich aufgrund der Trivialnamenüberschneidungen auf die lateinischen Namen festlegen. Auch in der Lebensmittelbranche. Arbeits du in dem Bereich?

LG, Jens